
Técnica SSTD resolve dilema do pós-treinamento de IA em domínios específicos
Pesquisa publicada no arXiv propõe distilação com professor autogerado para adaptar modelos sem perder desempenho geral
O que aconteceu
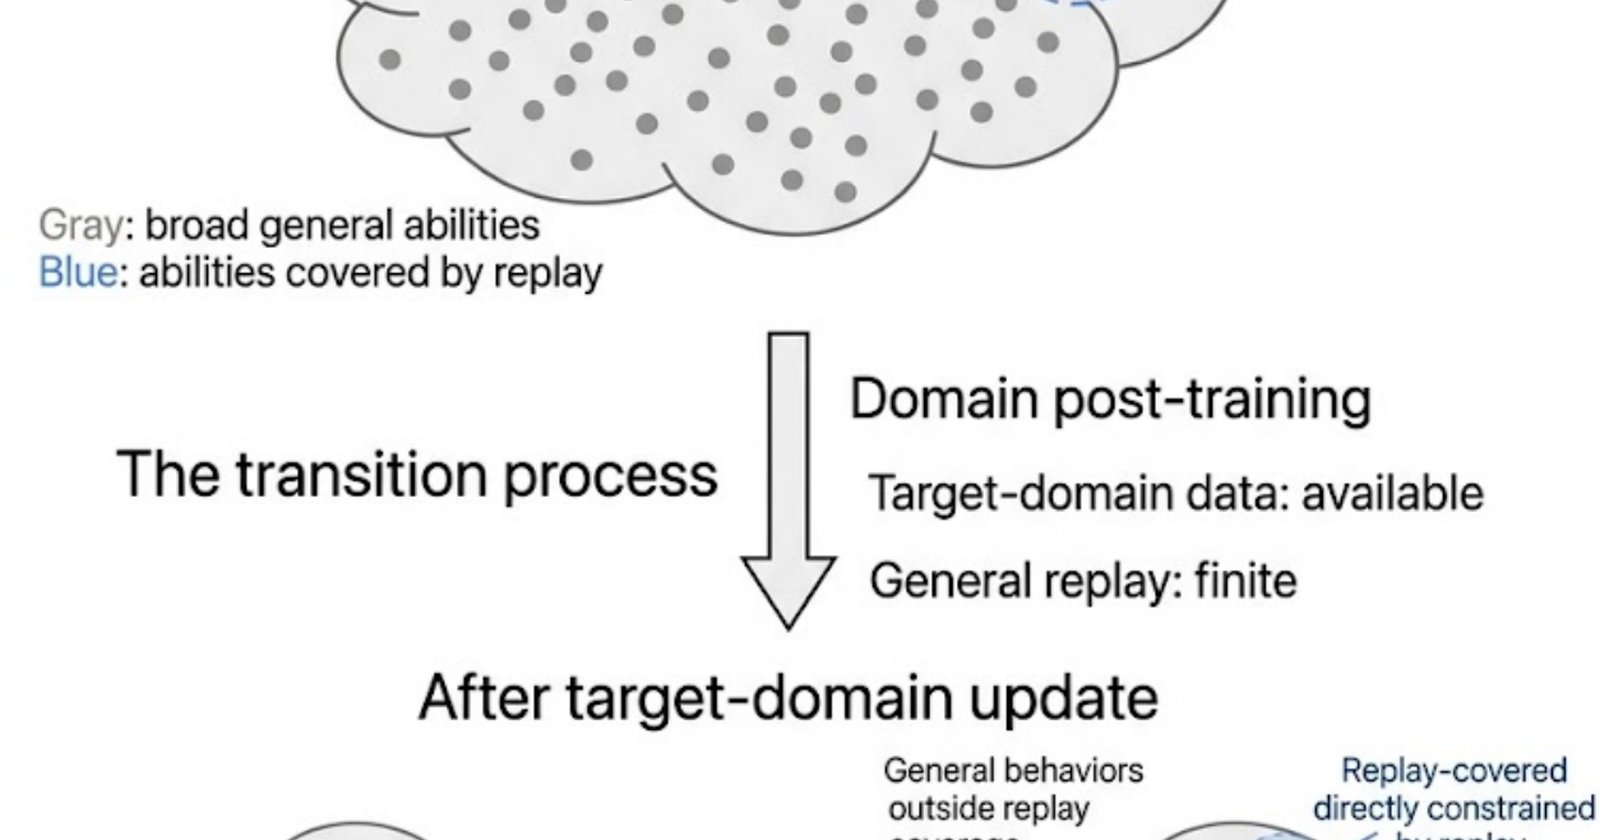
Pesquisadores submeteram em 16 de agosto de 2026 ao repositório arXiv (paper arXiv:2608.28647v1) uma nova abordagem para o treinamento direcionado de modelos de linguagem. O método, batizado de Self-Specialized Teacher Distillation (SSTD), é um processo de duas etapas. Na primeira, uma cópia do modelo base é treinada para se tornar um "professor" do domínio-alvo. Na segunda, a distribuição de tokens desse professor é destilada para um "aluno", usando prefixos gerados pelo próprio aluno (distilação "on-policy").
A técnica foi testada em três tarefas de domínio específico: raciocínio numérico financeiro, resposta a perguntas médicas e identificação de fundamentação jurídica. O resultado central é que o SSTD retém grande parte da melhoria de desempenho que o treinamento direto (fine-tuning) oferece para o domínio-alvo. Ao mesmo tempo, a média de pontuação em um conjunto de testes gerais aumentou de 4,8 a 5,0 pontos no ponto de operação reportado, comparado ao fine-tuning direto.
A pesquisa afirma que o padrão se mantém em diferentes tamanhos de modelo Qwen3 e também em uma arquitetura base (backbone) Gemma. O método não requer um professor externo ou um corpus de dados replay representativo, o que é uma vantagem prática significativa.
Contexto
O problema central que a pesquisa ataca é conhecido como "catastrophic forgetting" ou degradação no pós-treinamento. Quando um modelo base (genérico) é ajustado com foco em um domínio (como finanças ou medicina), ele ganha desempenho na tarefa nova, mas frequentemente perde a capacidade de executar bem outras tarefas gerais que dominava antes. Isso é problemático para empresas que precisam de um único modelo especializado que também mantenha funções auxiliary.
A abordagem comum para mitigar isso envolve usar um corpus de "replay" com dados gerais durante o treinamento direcionado. Porém, na prática, montar um conjunto de dados replay que seja verdadeiramente representativo de todas as capacidades do modelo base é extremamente difícil e custoso. O SSTD propõe uma alternativa elegante: usar o próprio modelo como ponto de referência para preservar as capacidades gerais.
A pesquisa detalha que o treinamento do "professor" combina supervisão padrão do domínio-alvo com duas técnicas-chave: ponderação de tokens-chave ciente do modelo base e alinhamento de distribuição com o modelo base congelado. Essas técnicas visam ancorar o professor às capacidades originais do modelo.
Por que importa
Para empresas e desenvolvedores de IA, o SSTD oferece um caminho mais barato e prático para criar modelos especializados. Adaptar um LLM para, por exemplo, analisar contratos jurídicos ou relatórios financeiros sem prejudicar sua utilidade geral (como responder a perguntas de suporte ou resumir textos) é um desafio comercial real. A técnica elimina a necessidade de investir na curadoria de grandes datasets de replay, que muitas organizações não têm.
O ganho de 4,8 a 5,0 pontos médios em testes gerais é substancial. Em benchmarks de IA, diferenças de poucos pontos podem significar a fronteira entre um modelo viável para produção e um que gera muitos erros. Isso mostra que o método não é apenas uma sutileza acadêmica, mas tem impacto mensurável na qualidade do modelo final. O fato de funcionar tanto em modelos da família Qwen quanto na Gemma indica que a técnica pode ser amplamente aplicável.
Impacto
O impacto de curto prazo será a experimentação por equipes de pesquisa e desenvolvimento em empresas de tecnologia e instituições financeiras/de saúde que já utilizam LLMs. A publicação aberta no arXiv permite replicação imediata. No médio prazo, vemos duas consequências:
1. **Democratização da Especialização**: Startups e empresas menores, que não dispõem de grandes times de dados ou orçamentos para treinamento extensivo, poderão adaptar modelos open-source (como Qwen3 e Gemma) para nichos específicos com menor custo operacional.
2. **Novos Produtos de IA Verticalizados**: Ferramentas de análise financeira, assistentes médicos de primeiro atendimento e softwares de análise jurídica podem incorporar modelos mais robustos. Um assistente para analistas de crédito, por exemplo, poderia usar o SSTD para ganhar precisão em projeções financeiras sem perder a capacidade de redigir e-mails ou pesquisar informações na web.
A pesquisa também levanta uma questão sobre a governança de IA: modelos adaptados que mantêm funcionalidades gerais são mais previsíveis e menos propensos a ter "lacunas" de comportamento imprevisíveis, o que é relevante para setores regulados.
O que muda
A descoberta principal muda a narrativa de que adaptar um modelo para um domínio é um jogo de soma zero entre especialização e generalização. O SSTD prova que, com uma distilação bem arquitetada, é possível ter os dois mundos. O método muda também a abordagem técnica: em vez de focar apenas nos dados de treinamento, foca na relação estrutural entre o modelo original e o adaptado, usando um deles como âncora do outro.
O que vem agora
O próximo passo natural, não especificado no artigo, é a implementação prática e a validação em ambientes de produção. A pesquisa é do tipo que gera trabalhos derivados rapidamente. Espera-se que, nos próximos 6 a 12 meses, veja-se a integração de técnicas inspiradas no SSTD em ferramentas de adaptação de modelos (model finetuning) de grandes provedores de cloud. O próprio método pode ser refinado para lidar com mais tipos de dados ou tarefas multimodais. O arXiv oferece o PDF completo do estudo para análise detalhada pela comunidade.