
ThermoDPO: novo método de IA corrige falha que desloca modelos do mundo real
Técnica corrige desvio dos modelos de imagem que saem da 'moldura' do mundo real após treinamento.
O que aconteceu
Pesquisadores publicaram em 20 de agosto de 2026, no repositório arXiv, um estudo que formaliza e propõe uma solução para o 'manifold drift' em modelos de fluxo (flow matching). O problema ocorre quando métodos de otimização por preferência, usados para alinhar modelos de IA, alteram as trajetórias de geração e movem as amostras finais para fora da distribuição de dados original em que o modelo foi pré-treinado.
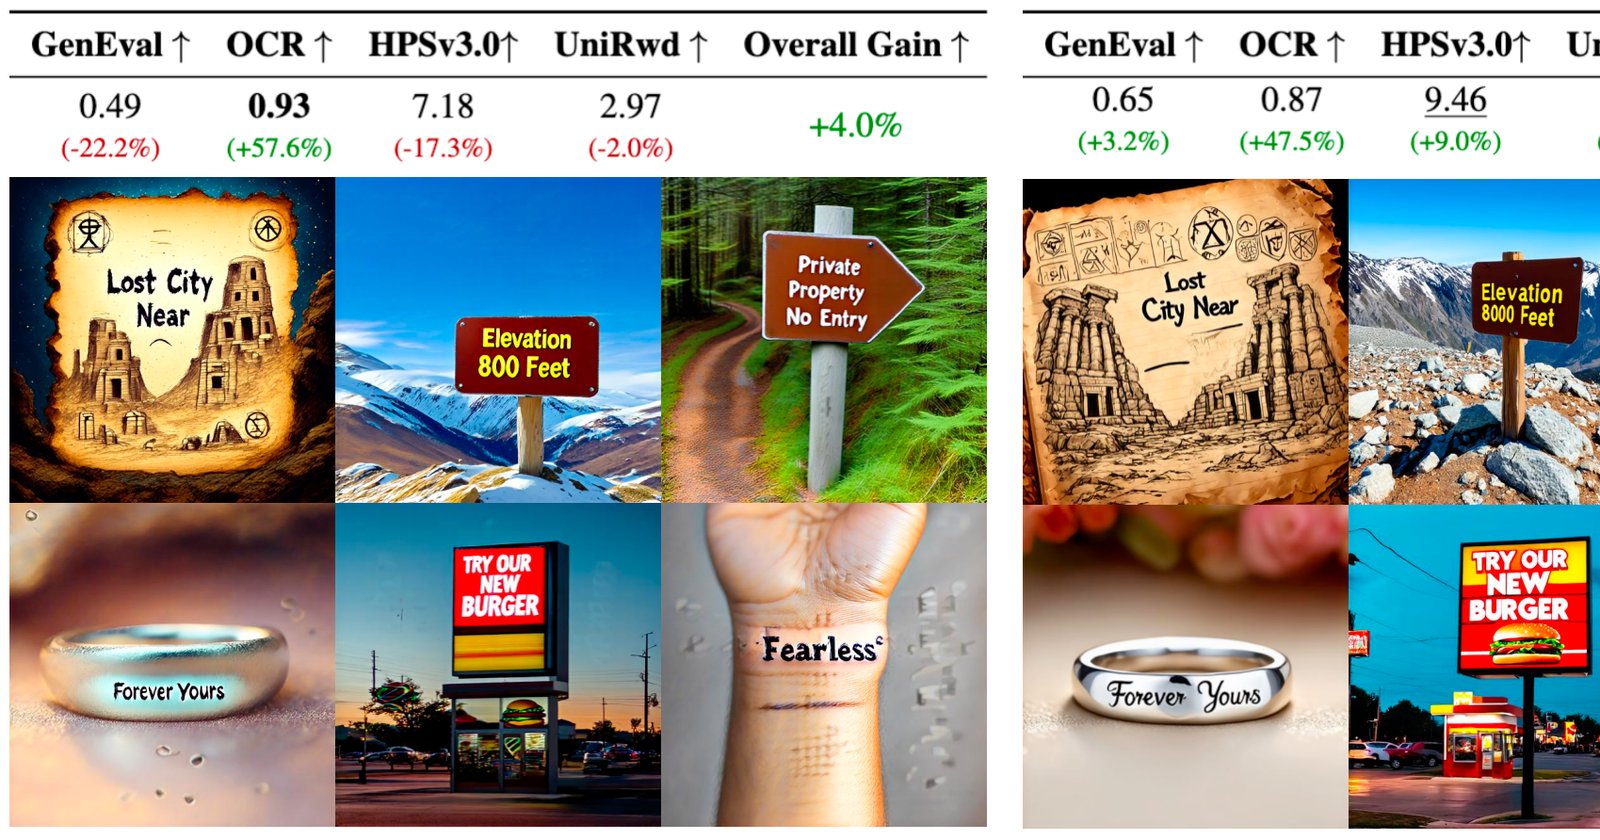
A equipe propõe o ThermoDPO, um objetivo com temperatura controlada que ancora a otimização nas amostras preferidas, controlando a distância do 'manifold' original. Para validar, apresentam o ThermoDPO-weighted, uma variante ponderada. Em testes no principal benchmark toy, o método alcançou um StrictScore de 0,899, contra 0,629 do FlowDPO e 0,857 do FlowDPO+RFT. No Stable Diffusion 3.5-M (CFG = 4.5), o método melhorou a métrica OCR em 47,5% e a média de quatro métricas em 16,0%.
Contexto
A otimização por preferência (como DPO - Direct Preference Optimization) é um padrão para alinhar modelos generativos com o que os humanos preferem. Quando aplicada a modelos de 'flow matching' - uma técnica avançada para criar amostras de dados complexas - os ajustes baseados em recompensa podem deslocar os pontos de geração final. Isso significa que o modelo pode começar a gerar imagens ou dados que seguem sua lógica de treinamento, mas fogem do domínio realista em que foi inicialmente treinado, um fenômeno ligado ao 'reward hacking'.
Por que importa
Para desenvolvedores e pesquisadores de modelos de geração de imagem, como os da Stability AI (responsável pelo Stable Diffusion), esse estudo oferece uma explicação teórica e uma ferramenta prática para um problema persistente: como otimizar um modelo para seguir preferências sem comprometer a fidelidade de suas saídas ao mundo real. O ThermoDPO atua como uma âncora, potencializando métodos existentes como o FlowDPO.
Impacto
A correção do manifold drift pode permitir um ajuste mais seguro e preciso de modelos generativos em produção. Isso é crucial para aplicações que exigem alto realismo, como design gráfico, simulation e conteúdo para marketing. A melhoria de 47,5% no OCR (reconhecimento óptico de caracteres) do Stable Diffusion 3.5 sugerem ganhos imediatos na geração de imagens com texto, um caso de uso comum e historicamente problemático.
O que muda
A pesquisa estabelece uma base teórica mais sólida para alinhar modelos de fluxo, mostrando que a atualização de preferência desloca o manifold sempre que sua componente normal no deslocamento terminal é não nula. O ThermoDPO unifica, sob uma perspectiva de temperatura, técnicas anteriormente distintas como o finetuning por rejection sampling e o FlowDPO, oferecendo um framework mais abrangente para controle de qualidade.
O que vem agora
O próximo passo natural é a implementação e testes dessas técnicas em escala real com modelos maiores e mais complexos. A comunidade de código aberto provavelmente adaptará e testará o ThermoDPO em diferentes pipelines de treinamento para validar sua eficácia e eficiência computacional. A pesquisa também pode estimular novos trabalhos sobre restrições geométricas em métodos de alinhamento de IA.