
Transfer learning melhora previsão genômica em populações sub-representadas
Estudo cruza UK Biobank e Biobank Japan e mostra ganho em amostras pequenas, com perda de acurácia quando elas crescem
O que aconteceu
Em 3 de setembro de 2026, os pesquisadores Joey Poomarin Phloyphisut e Cory McLean, da Google Research, publicaram no blog oficial da empresa um estudo empírico sobre transfer learning para previsão genômica em populações sub-representadas. O trabalho avaliou a transferência de escores de risco poligênico (PRS, na sigla em inglês) treinados em centenas de milhares de europeus do UK Biobank (UKB) para amostras de uma população não europeia, o Biobank Japan (BBJ), coorte de quase 200 mil japoneses com fenotipagem profunda.
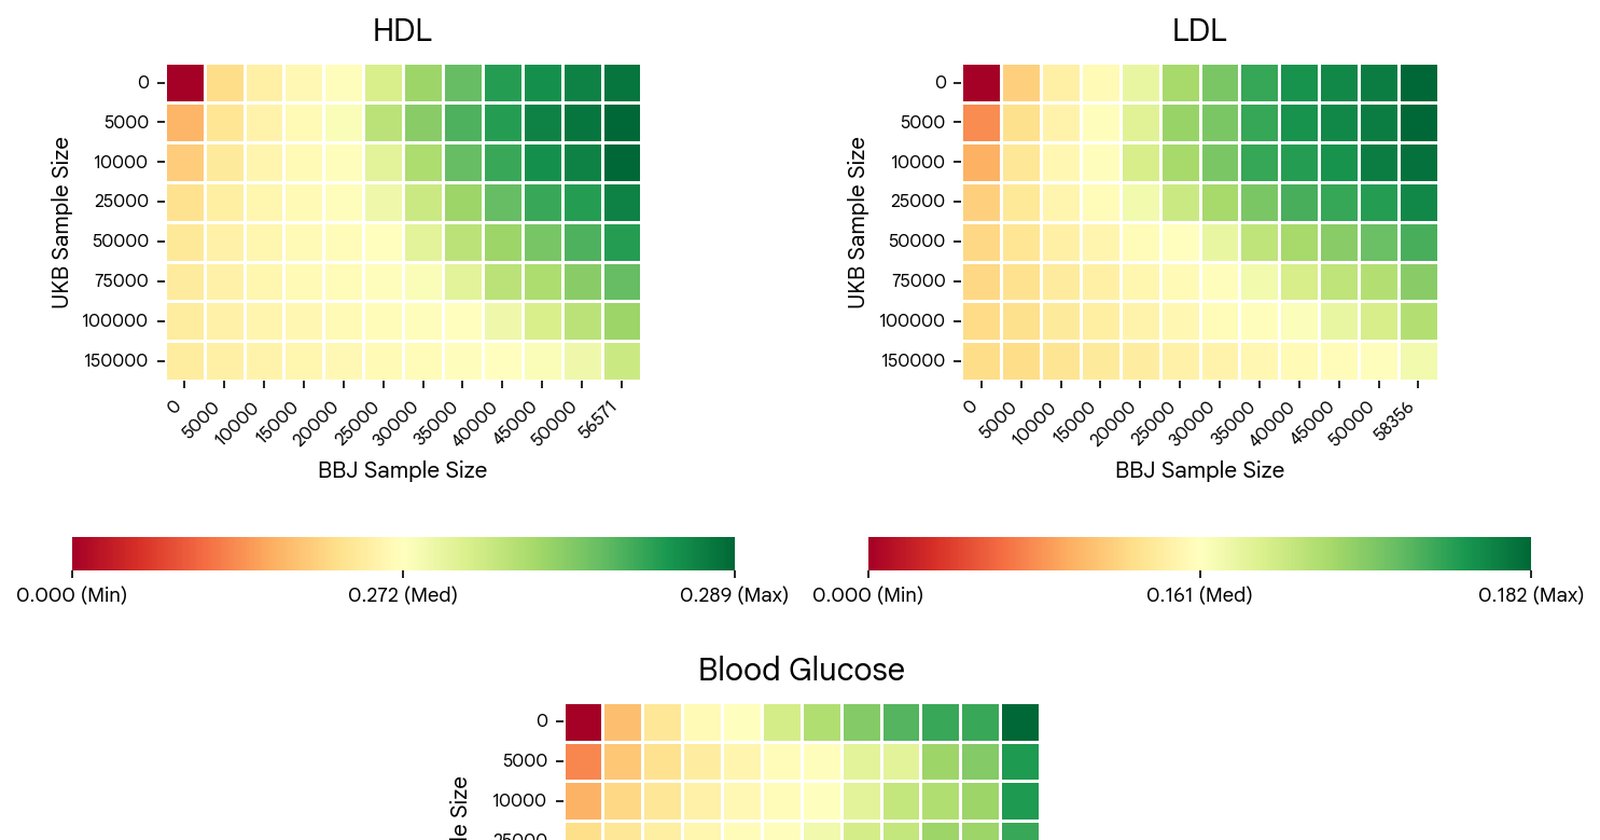
O resultado central tem duas faces. O transfer learning a partir de coortes europeias melhora a previsão de risco quando a população-alvo é pequena. Por outro lado, quando o tamanho da amostra da população que recebe o modelo cresce, a transferência degrada a acurácia, especialmente para características em que a arquitetura genética é específica daquela população.
A própria Google Research, que assina o estudo pelos dois engenheiros, apresenta o achado como uma forma de avaliar, com critérios sistemáticos e empíricos, como o treinamento de modelos entre populações deve ser feito.
Contexto
Os escores de risco poligênico são usados para prever risco de doenças a partir de variantes genéticas e costumam incorporar de centenas a milhões de marcadores. A adoção clínica desses escores ainda é baixa. Um motivo é histórico: os estudos de associação genômica ampla (GWAS, na sigla em inglês) avaliaram de forma esmagadora coortes europeias, o que provoca quedas severas de acurácia quando os modelos são aplicados a populações não europeias.
Essas perdas de precisão ocorrem por diferenças entre populações na arquitetura genética, na estrutura populacional e nas frequências alélicas das variantes. Além disso, conduzir um GWAS de novo com centenas de milhares de pessoas é proibitivo em custo para a maioria dos sistemas de saúde. O transfer learning surge como alternativa: pegar os resultados em larga escala do GWAS europeu e aumentá-los com um GWAS específico da população-alvo.
Por que importa
A existência de dois bancos de dados grandes e profundos, o UKB e o BBJ, permitiu aos pesquisadores fazer experimentos de ablação de dados, variando o tamanho tanto da população-alvo quanto da população europeia usada para criar o modelo. A avaliação cobriu oito características clínicas, entre elas índice de massa corporal, pressão arterial sistólica e diastólica, contagem de hemácias e de leucócitos e o colesterol HDL.
O objetivo primário declarado pelos autores é fornecer diretrizes sistemáticas e empíricas sobre como o treinamento de GWAS e de PRS entre populações deve ser realizado para otimizar o desempenho preditivo em uma população-alvo. Os dados europeus do UKB serviram de base para os escores transferidos, enquanto a amostra japonesa do BBJ recebeu esses modelos em diferentes tamanhos de coorte.
Impacto
Para sistemas de saúde e laboratórios que trabalham com populações sub-representadas, o estudo indica que não existe uma resposta única. Quando a coorte local é pequena, transferir um PRS construído sobre dados europeus acelera o ganho de precisão sem exigir uma coleta gigantesca. Quando essa coorte já tem volume expressivo, insistir na transferência pode piorar o resultado, e o caminho passa a ser um treino mais apoiado nos dados locais.
O ponto vale para países com alta diversidade de ancestralidade, como o Brasil, cuja população em geral está fora do eixo das grandes coortes europeias que dominaram os GWAS históricos. A diretriz prática é que a decisão de usar transfer learning depende do estágio de maturidade da coleta local de dados.
O que muda
A principal mudança é de método. Em vez de um fluxo fixo, em que todo modelo europeu é reaplicado sem ajuste, o trabalho indica que a transferência é uma ferramenta de início de percurso. Populações pequenas se beneficiam dela; conforme a amostra da população-alvo cresce, a dependência do dado europeu deve cair, sob risco de degradação da acurácia, principalmente em características com arquitetura genética específica.
O que vem agora
O artigo não traz cronograma de estudos futuros. O que os autores entregam é um conjunto de evidências empíricas para basear decisões de coleta e de treinamento, com o conteúdo completo da metodologia disponível no blog oficial do Google Research desde o comunicado de 3 de setembro de 2026.
Fontes
- Google Research Blog: Transfer learning for genomic prediction in underrepresented populations (https://research.google/blog/transfer-learning-for-genomic-prediction-in-underrepresented-populations/)