
Wuying-Browser-Agent propõe framework unificado para agentes de IA em web
Novo framework aberto e benchmark de 350 tarefas visam fechar a lacuna entre testes controlados e navegação real na web
O que aconteceu
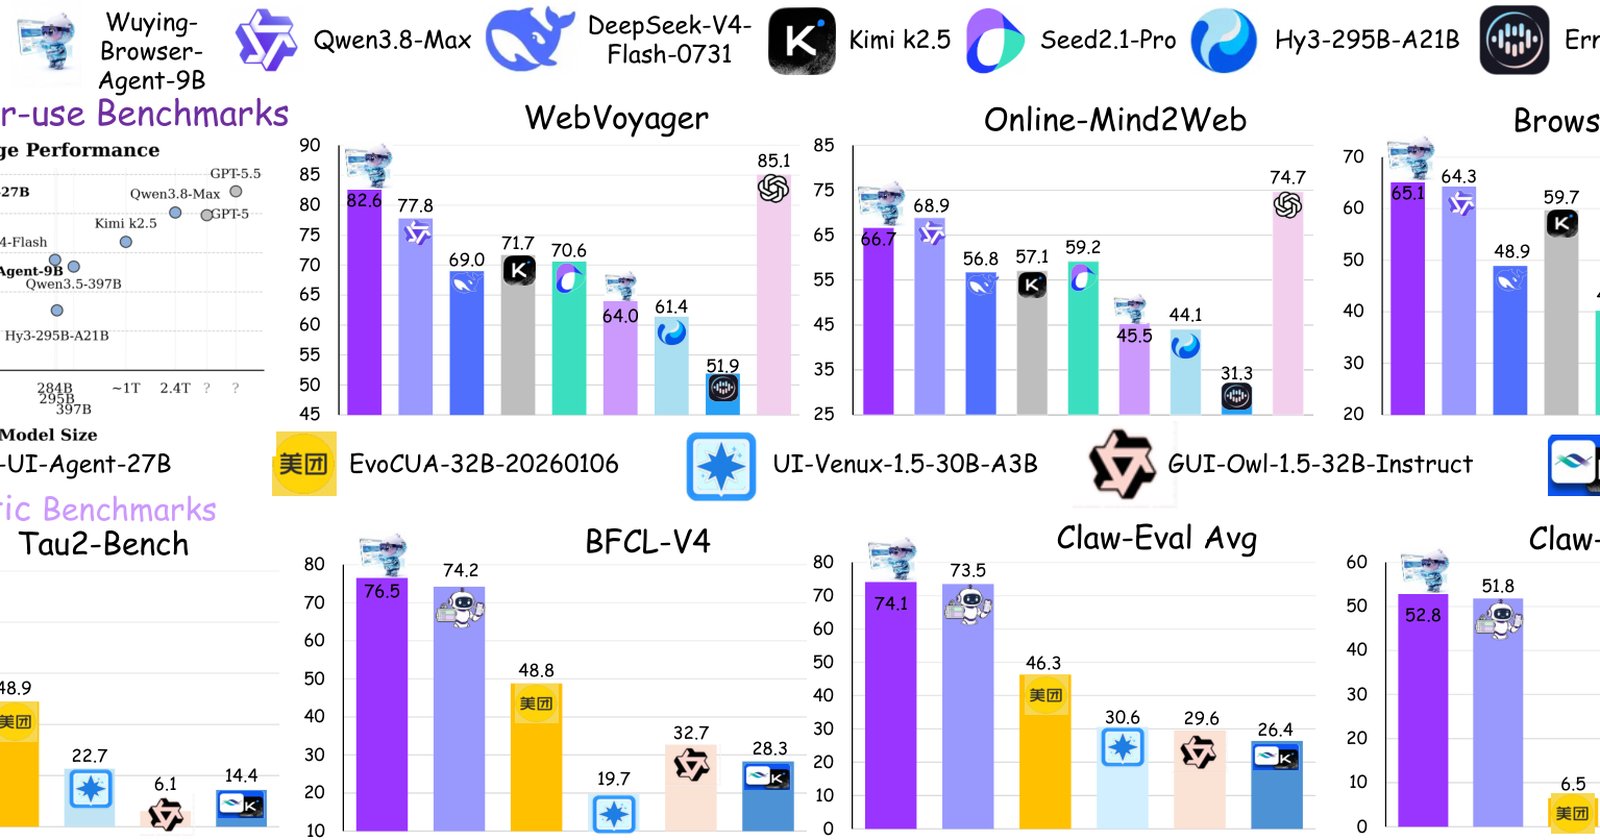
A equipe de pesquisa do Wuying divulgou um novo framework para agentes de navegação web e um benchmark de avaliação que mira diretamente nos modos de falha de "horizonte longo" (long-horizon). O sistema, chamado Wuying-Browser-Agent, é composto por quatro componentes principais: um ambiente de execução estruturado para estabilidade; um método de treinamento chamado RUIC-SFT que foca em recuperar erros e navegar interfaces complexas; um otimizador online (DAO-GRPO) para melhorar a tomada de decisão em passos longos; e o novo benchmark BrowserBench.
O BrowserBench é descrito como um benchmark bilingue com 350 tarefas reais da web, que em média exigem 37,9 etapas para serem concluídas — bem acima dos benchmarks existentes. O modelo resultante, Wuying-Browser-Agent-27B, alcançou 80,6% de acurácia no WebVoyager, 66,7% no Online-Mind2Web e 65,1% no próprio BrowserBench, estabelecendo um novo estado da arte open-source para tarefas de uso do navegador (arXiv:2608.17319v1).
Contexto
Agentes baseados em grandes modelos de linguagem (LLMs) têm demonstrado desempenho notável em demonstrações curtas e controladas. No entanto, a pesquisa aponta que a implantação real é "fundamentalmente diferente": um agente precisa sustentar dezenas de decisões em sites ao vivo, recuperando-se de erros e navegando em interfaces de usuário (UIs) complexas. O argumento central do trabalho é que a simples escala não resolve essa lacuna. O Wuying-Browser-Agent foi projetado para endereçar esses desafios em cada nível do pipeline, de execução a avaliação.
Por que importa
Para empresas e desenvolvedores que buscam automatizar tarefas em web com IA, este trabalho sinaliza uma mudança de foco. A obsessão por benchmarks pontuais pode ser substituída por sistemas que provam sua robusteza em cenários longos e imprevisíveis. A capacidade de um agente não só executar uma sequência de passos, mas também se recuperar de erros e adaptar-se a layouts inesperados, é crucial para a automação confiável de processos que hoje ainda dependem de humanos. A pesquisa também demonstrou que o pipeline se transfere para outras tarefas agentes, com média de 73,8 em três outros benchmarks.
Impacto
No curto prazo, o BrowserBench deve servir como uma referência mais exigente para validar novos modelos de agente web. Modelos que obtiverem bom desempenho nele terão argumentos mais fortes para seu uso em cenários reais. No médio prazo, os componentes técnicos apresentados, como o método de treinamento em trajetórias de recuperação e o otimizador consciente de divergência, podem influenciar a arquitetura de sistemas agentes comerciais, focando mais em resiliência e menos em performance em demos isoladas.
O que muda
A principal mudança é a própria exigência do benchmark. Um agente que só funciona com 10 passos não é comparável a um que precisa de 40. Isso força pesquisadores e engenheiros a projetar sistemas com memória de longo prazo, planejamento e supervisão contínua. A pesquisa também destaca que a execução em ambientes web reais é fundamentalmente instável — diferentemente de simulações — e propõe um "harness" estruturado para gerenciar essa instabilidade, algo que pode se tornar padrão.
O que vem agora
O código e os dados do benchmark devem se tornar disponíveis para a comunidade (o artigo cita repositórios associados). O próximo passo natural é ver se outros grupos conseguem replicar os resultados ou estendê-los. A demonstração de que o mesmo pipeline funciona além do domínio web sugere que abordagens unificadas de treinamento e avaliação de agentes podem ganhar tração em outras áreas de automação por IA.