Ontologia médica organiza 52.949 relatos de caso clínico

Ontologia médica organiza 52.949 relatos de caso clínico

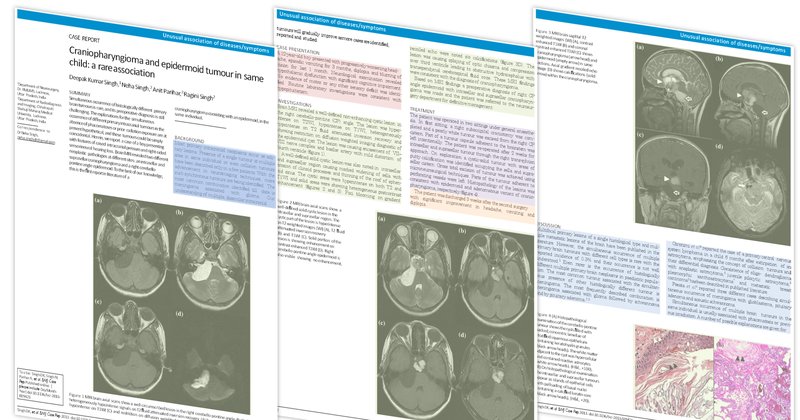
Artigo no arXiv apresenta um sistema multimodal que organiza resumos clínicos, imagens médicas e entidades biomédicas de 52.949 relatos de caso publicados entre 2000 e 2021 em uma ontologia médica pesquisável, com foco em ajudar clínicos iniciantes a identificar doenças raras.
Por Redação Mapa Paper19 set
AutoData: agente busca dados de pré-treinamento sozinho

AutoData: agente busca dados de pré-treinamento sozinho

O AutoData, agente descrito no arXiv em 17 de setembro de 2026, busca algoritmos executáveis de seleção de dados de pré-treinamento em vez de apenas pesos de mistura. Em uma busca noturna, superou pipelines de curadoria humanos e melhorou a métrica CORE ao transferir a receita para escalas maiores.

Por Redação Mapa Paper19 set
Trading com IA é vulnerável a ataques via redes sociais

Trading com IA é vulnerável a ataques via redes sociais

Um paper no arXiv (2609.19789v1) mostra que sistemas de trading multiagente com LLM são vulneráveis a ataques que entram apenas por posts de redes sociais. Mesmo atacantes simples degradam o perfil risco-retorno e reduzem com força as razões de Sharpe.

Por Redação Mapa Paper19 set
Depth Control Protocol questiona métrica de profundidade em LLMs recursivos

Depth Control Protocol questiona métrica de profundidade em LLMs recursivos

O Depth Control Protocol, proposto em artigo submetido ao arXiv em 17 de setembro de 2026, separa três fatores que a truncagem de profundidade mede de uma só vez: número de aplicações de bloco, volume de computação distinta e posição da cabeça de leitura no fluxo residual. O paper sustenta que a inclinação lida hoje confunde os três e é interpretada como se refletisse apenas um.

Por Redação Mapa Paper19 set
Estudo aponta falha de raciocínio composicional em LLMs pós-RL

Estudo aponta falha de raciocínio composicional em LLMs pós-RL

Paper no arXiv formaliza o raciocínio composicional com um framework de grafo de dependências e encontra uma assimetria consistente: ensinar habilidades isoladas não garante que o modelo saiba combiná-las, enquanto treinar em tarefas compostas transfere melhor para as partes.

Por Redação Mapa Paper18 set
AutoTuring testa se agentes de IA entendem arquitetura de computadores

AutoTuring testa se agentes de IA entendem arquitetura de computadores

O framework AutoTuring entrega o mesmo espaço de 15 dimensões ao mesmo agente duas vezes, uma com nomes de arquitetura e outra com variáveis anônimas. Na cesta de nove kernels FP16 GEMM, o agente que enxerga significado supera o H200 modelado em 5,4% e a versão cega em 12,3%.

Por Redação Mapa Paper18 set
RETD corrige instabilidade do ETD com passo constante

RETD corrige instabilidade do ETD com passo constante

O paper arXiv:2609.19170 propõe o RETD, correção pós-choque que estabiliza o aprendizado ETD sob passo constante e recupera exatamente o ponto fixo do método original. Um counterexample de dois estados mostra que o mapa médio do ETD contrai enquanto o produto amostrado diverge.

Por Redação Mapa Paper18 set
Estudo mapeia 14.767 benchmarks de LLMs no arXiv

Estudo mapeia 14.767 benchmarks de LLMs no arXiv

Um estudo do arXiv mapeou 14.767 papers de benchmarks para LLMs publicados entre janeiro de 2022 e agosto de 2026. A avaliação feita por modelos de linguagem cresce, e a pesquisa pergunta se isso gera evidência independente ou reproduz os vieses dos próprios modelos.

Por Redação Mapa Paper18 set
Fine-tuning corrige mode collapse em LLMs, diz estudo

Fine-tuning corrige mode collapse em LLMs, diz estudo

Estudo no arXiv mostra que mode collapse e superdispersão em LLMs são erros de amostra finita do fine-tuning supervisionado. Com mais dados de treino, a diversidade das respostas converge para a do alvo humano ou sintético.

Por Redação Mapa Paper16 set
CADWorld: benchmark testa agentes de IA em CAD no FreeCAD

CADWorld: benchmark testa agentes de IA em CAD no FreeCAD

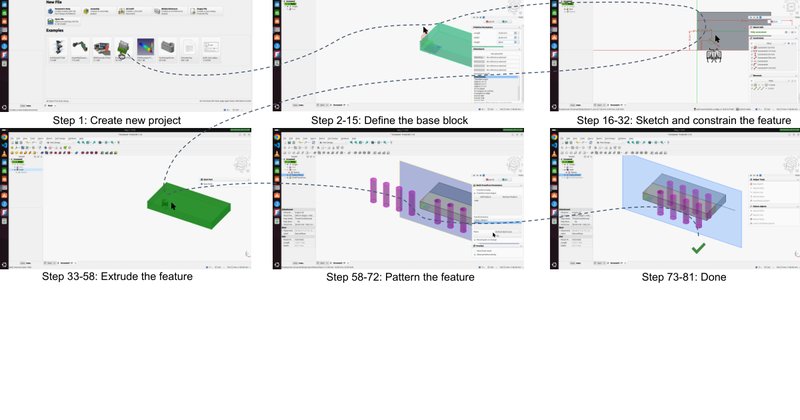
O CADWorld, benchmark publicado no arXiv em 14 de setembro de 2026, avalia agentes de IA dentro do FreeCAD em 200 tarefas de engenharia mecânica. O melhor agente acerta 17,5%, contra 87,0% da referência especialista.

Por Redação Mapa Paper16 set