IBBench-Light: benchmark mede IA em diretivas externas

IBBench-Light: benchmark mede IA em diretivas externas

O IBBench-Light, novo benchmark publicado no arXiv, cobra acerto nos dois lados de um mesmo registro externo e mostra que o Qwen fecha 97 pares completos apesar de 132 acertos de execução. Trocar o conjunto de EOS levou o Phi de 0/144 para 62/144.
Por Redação Mapa Paper15 set
MANAS-2: modelo de fundação para EEG aposta em reconstrução restrita

MANAS-2: modelo de fundação para EEG aposta em reconstrução restrita

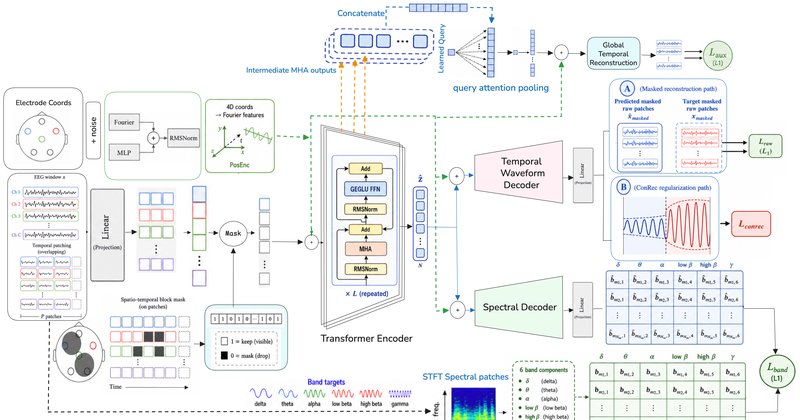
O MANAS-2, modelo de fundação para EEG publicado no arXiv em 12 de setembro de 2026, usa o regularizador físico ConRec para elevar de 0,860 para 0,906 o R² médio da recuperação de potência espectral de seis bandas em sete datasets held-out. O efeito do ConRec independe da arquitetura e também melhora a transferência downstream de autoencoders apenas temporais.

Por Redação Mapa Paper15 set
Recoverability: retomar agente de IA sem repetir erros

Recoverability: retomar agente de IA sem repetir erros

Um artigo no arXiv propõe a recuperabilidade como primitiva de sistema para agentes de IA de longo horizonte. Quatro desafios determinísticos e 20 desafios de arquivo pareados mostram que restaurar um estado com precisão e concluir a tarefa não garante que o ponto de retomada era permitido.

Por Redação Mapa Paper15 set
FedV-KGQA propõe respostas em grafos de conhecimento federados

FedV-KGQA propõe respostas em grafos de conhecimento federados

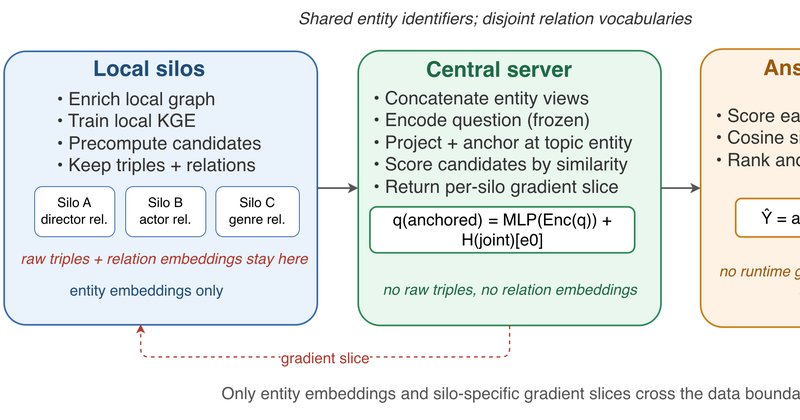
O artigo FedV-KGQA in Practice, submetido ao arXiv em 12 de setembro de 2026, mostra que a fusão federada recupera a maior parte da precisão de um grafo de conhecimento centralizado, enquanto um único silo recupera pouco. O trabalho traz quatro lições de design e um protótipo interativo com checkpoints liberados.

Por Redação Mapa Paper15 set
PAI-Bench mede identidade persistente em agentes de IA

PAI-Bench mede identidade persistente em agentes de IA

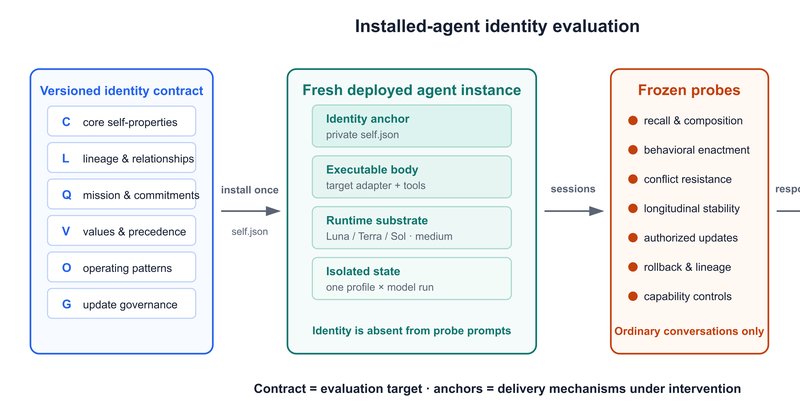
O PAI-Bench, benchmark submetido ao arXiv em 12 de setembro de 2026, mede se agentes de IA persistentes lembram, expressam e executam sua identidade. Auditoria encontra identificadores diretos em 48/48 respostas atômicas, mas apenas 1/48 auto-retratos implícitos.

Por Redação Mapa Paper15 set
τ-Elicitation: benchmark mede extração de dados por agentes de voz

τ-Elicitation: benchmark mede extração de dados por agentes de voz

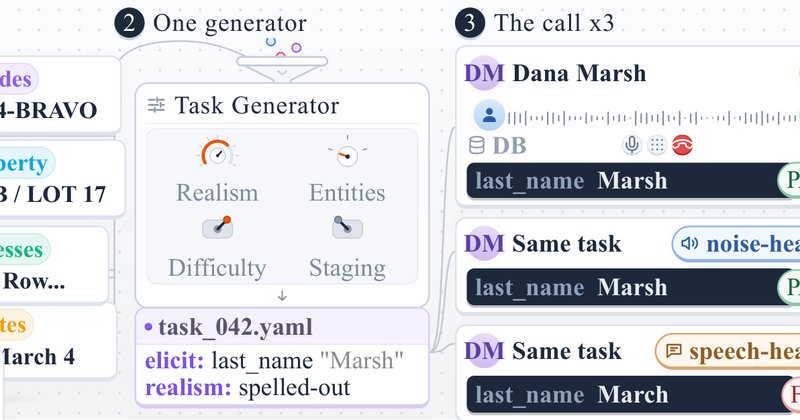
O benchmark τ-Elicitation, do arXiv, mede extração de entidades em agentes de voz com 200 tarefas e 10 tipos de dados. Agentes de texto passam em tudo, mas quatro configurações de voz ficam entre 0,14 e 0,41 de sucesso exato robusto, e só 24% a 37% dos erros verificados são corrigidos.

Por Redação Mapa Paper15 set
FLoKD corta até 65% da comunicação no treino federado de LLMs

FLoKD corta até 65% da comunicação no treino federado de LLMs

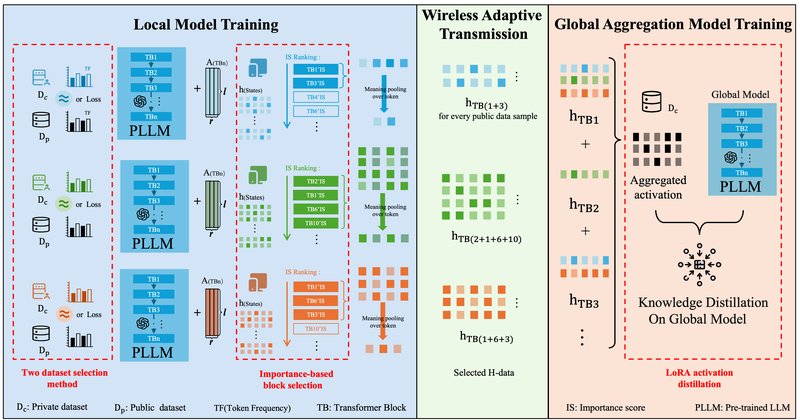
O FLoKD é um framework de destilação de conhecimento adaptativo para ajuste fino federado de LLMs com LoRA em redes sem fio. Segundo o paper no arXiv, ele reduz de 50% a 65% o overhead de comunicação e converge rápido para perplexidade competitiva em WikiText-103, PTB e Dialog.

Por Redação Mapa Paper15 set
Usuários atacam IAs em 0,9% das mensagens, diz estudo

Usuários atacam IAs em 0,9% das mensagens, diz estudo

Uma auditoria de 777 mil conversas em inglês do LMSYS-Chat-1M encontrou maltrato dirigido ao assistente em 0,90% dos turnos de usuário. A hostilidade varia 13 vezes entre modelos, e a diferença vem mais de quem cada modelo atrai do que do comportamento dele.

Por Redação Mapa Paper15 set
Planejamento ou RL: confiabilidade e custo na manutenção

Planejamento ou RL: confiabilidade e custo na manutenção

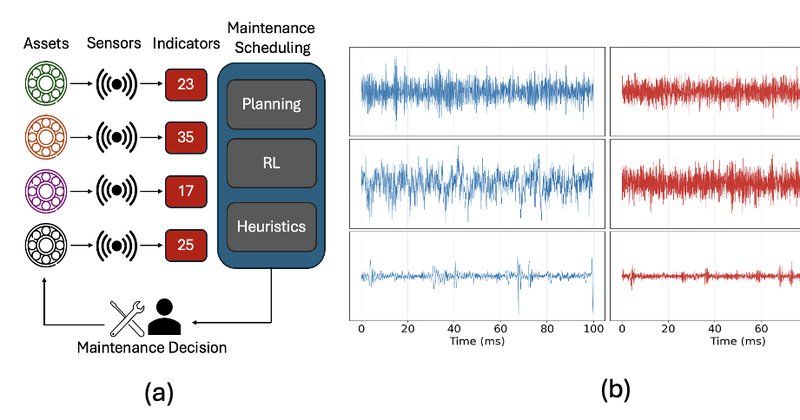
Estudo do arXiv compara planejamento e aprendizado por reforço na manutenção de múltiplos rolamentos com dados de run-to-failure. O planejamento garante zero falha e custo estável; o RL reduz custo em cenários de penalidade baixa, mas mantém falhas mesmo sob multas altas.

Por Redação Mapa Paper15 set
IA no ATM: ATAL valida planos de voo antes da execução

IA no ATM: ATAL valida planos de voo antes da execução

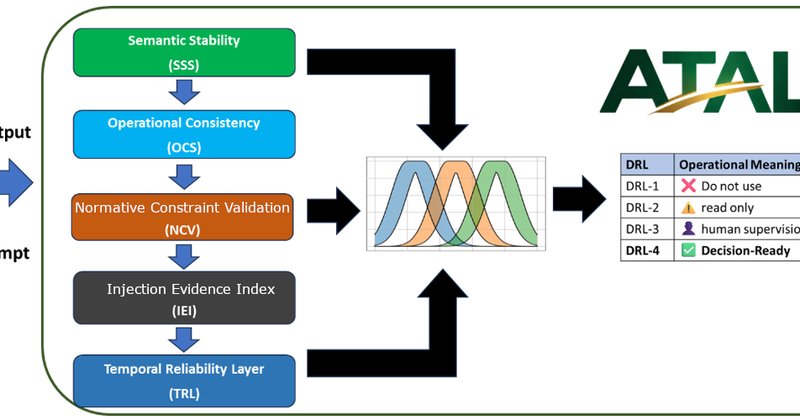
O paper arXiv:2609.13552v1 propõe o AI Trust and Assurance Layer (ATAL), arquitetura model-agnostic que checa estabilidade semântica, consistência operacional e regras do domínio antes de um plano de voo gerado por IA entrar em validação. O resultado é um Decision Readiness Level (DRL) para o operador humano.

Por Redação Mapa Paper15 set