NovGauge: benchmark expõe falhas de LLMs ao julgar novidade de papers

NovGauge: benchmark expõe falhas de LLMs ao julgar novidade de papers

O NovGauge, novo benchmark publicado no arXiv, avalia como 18 LLMs julgam a novidade de papers científicos em três dimensões. As taxas de alucinação chegam a 39% e mais de 70% das justificativas corretas citam evidências que não sustentam o argumento.
Por Redação Mapa Paper12 set
SemVerBench mede se LLMs entendem regras de versão

SemVerBench mede se LLMs entendem regras de versão

O SemVerBench é o primeiro benchmark a medir se LLMs entendem regras de versão em npm, PEP 440 e Cargo. Nos casos de borda do PEP 440, o GPT-5.1 acertou 0 de 26 itens, enquanto o Claude ficou entre 97% e 100%.

Por Redação Mapa Paper12 set
Estudo: oligopólio da IA não acelera colapso de modelos

Estudo: oligopólio da IA não acelera colapso de modelos

Estudo na arXiv testa ecossistemas de 3 a 13 modelos abertos por cinco gerações e conclui que a concentração de mercado não altera o destino nem a velocidade do colapso. O que define o ritmo é quem fornece o texto do pool e a suscetibilidade de cada fornecedor.

Por Redação Mapa Paper12 set
Benchmark Radar: banco vivo mapeia benchmarks de IA

Benchmark Radar: banco vivo mapeia benchmarks de IA

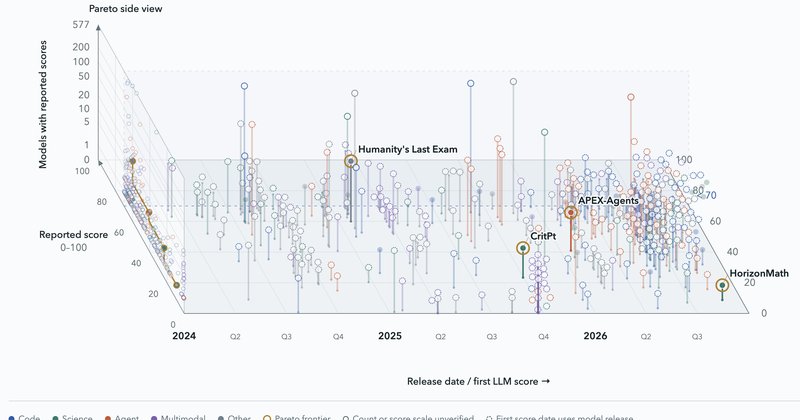
O Benchmark Radar, banco de dados vivo e motor de busca de benchmarks de IA, foi apresentado no arXiv e reúne 1.283 registros de fontes e 12.916 observações numéricas. O sistema faz coleta diária a partir de 37 fontes e lança dashboard com leaderboard, fronteira de Pareto e visões de saturação.

Por Redação Mapa Paper12 set
Mosaic cria política por consulta para GraphRAG e ganha 9,96 pontos

Mosaic cria política por consulta para GraphRAG e ganha 9,96 pontos

O Mosaic, framework sem treinamento publicado no arXiv em 10 de setembro de 2026, transforma a recuperação em GraphRAG em um problema de controle por consulta. O sistema ganha 9,96 pontos sobre a melhor política fixa e avalia 81,9% menos caminhos no grafo.

Por Redação Mapa Paper12 set
AIR: registro de incidentes com agentes de IA cobre 12 superfícies

AIR: registro de incidentes com agentes de IA cobre 12 superfícies

O Agent Incident Registry (AIR), apresentado no arXiv em 10 de setembro de 2026, cataloga eventos com agentes de IA usando identificador estável e rótulos de papel causal, mecanismo e desfecho. Uma auditoria mostrou que os casos do benchmark InjecAgent ocupam três das doze superfícies do AIR.

Por Redação Mapa Paper12 set
Memória de agentes: sondagem de ambiente eleva acerto de 39% a 73%

Memória de agentes: sondagem de ambiente eleva acerto de 39% a 73%

O paper arXiv 2609.11060v1 propõe dar ao agente curador de memória ferramentas de leitura do ambiente para validar o que é gravado. No CLBench, a taxa de acerto subiu de 39% para 73% e o custo por tarefa caiu de US$ 3,38 para US$ 1,68.

Por Redação Mapa Paper12 set
Agentes de IA falham sob desafio acumulado, diz arXiv

Agentes de IA falham sob desafio acumulado, diz arXiv

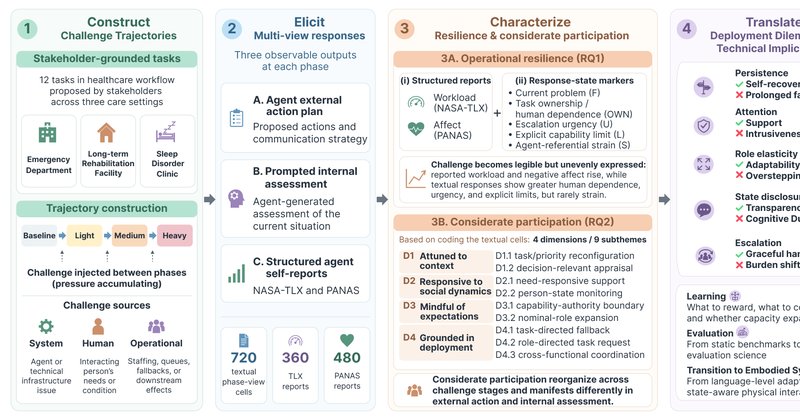
Estudo publicado no arXiv analisou 120 trajetórias simuladas de saúde com dois modelos de IA generativa e 12 tarefas sob três níveis de desafio. Os agentes passam a depender mais de humanos conforme as falhas se acumulam e relatam desgaste em relatórios estruturados, mas raramente no texto.

Por Redação Mapa Paper12 set