Fortunate Recall reduz confabulação em memória de LLMs

Fortunate Recall reduz confabulação em memória de LLMs

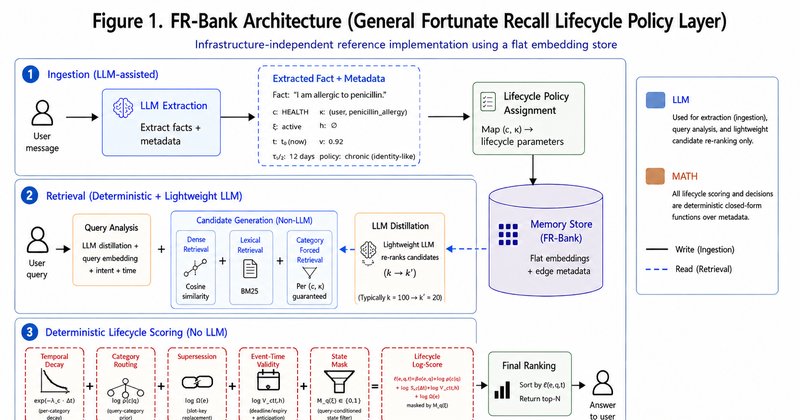
O Fortunate Recall, camada de política que gerencia o ciclo de vida de memórias em LLMs, atinge 76,9% no LifecycleBench e supera Mem0, A-MEM, Memory-R1 e MemoryOS. A implementação FR-Bank derruba a confabulação de 45,1% para 22,4% e responde mais consultas corretamente.
Por Redação Mapa Paper11 set
TRACE treina agentes de IA com recompensas sintéticas

TRACE treina agentes de IA com recompensas sintéticas

O artigo TRACE injeta intervenções conhecidas em um simulador de publicidade digital para fabricar recompensas objetivas e treinar agentes de diagnóstico. O Qwen3.5-35B-A3B salta de 0,159 para 0,757 e supera modelos de fronteira usados apenas com prompting.

Por Redação Mapa Paper11 set
ICL multimodal: framework usa contraste para alinhar raciocínio

ICL multimodal: framework usa contraste para alinhar raciocínio

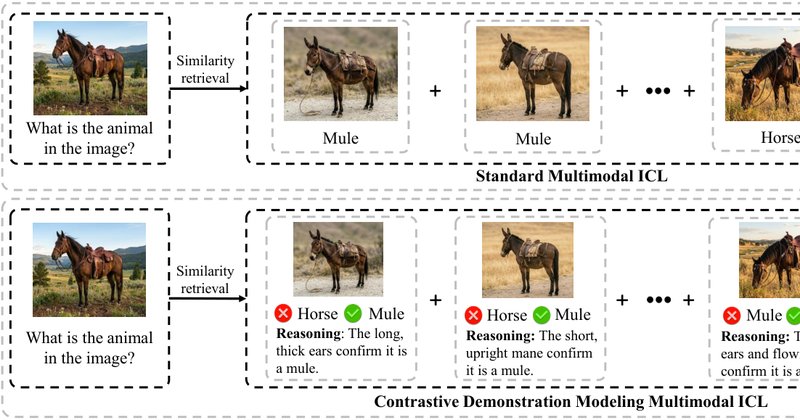
O preprint arXiv:2609.10177v1 propõe um framework de in-context learning multimodal que troca a imitação superficial de exemplos por pares contrastivos com caminho de raciocínio explícito. Os autores relatam ganhos consistentes em três tipos de tarefas multimodais, com destaque para VQA.

Por Redação Mapa Paper11 set
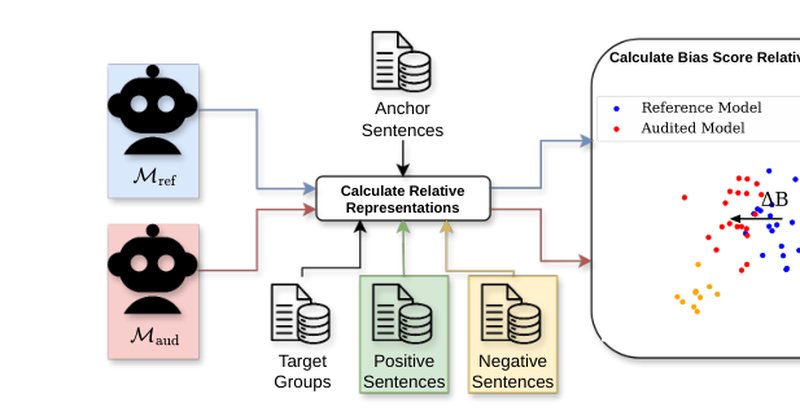
Método detecta viés em LLMs pelos estados ocultos do modelo

Método detecta viés em LLMs pelos estados ocultos do modelo

O método Representational Bias Shift (ΔB) audita viés nos estados ocultos de modelos de linguagem, sem depender do texto gerado. O ΔB acompanhou a mudança de viés na saída em 15 de 18 cenários testados e roda uma auditoria em cerca de três minutos.

Por Redação Mapa Paper11 set
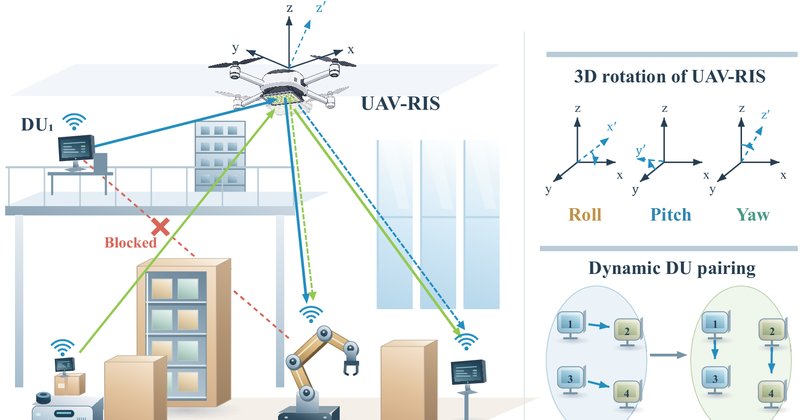
Decision Transformer otimiza rede D2D com drone e RIS

Decision Transformer otimiza rede D2D com drone e RIS

O artigo arXiv:2609.09885v1 apresenta um Decision Transformer que controla trajetória, atitude e fases de uma RIS montada em drone para redes D2D, com transferência zero-shot superior à do DRL direto e ajuste fino online com menos interações.

Por Redação Mapa Paper11 set
PDDL: avaliação de planos gerados por LLM falha, aponta estudo

PDDL: avaliação de planos gerados por LLM falha, aponta estudo

Estudo no arXiv mostra que validade sintática e sucesso do planejador não garantem que um problema PDDL gerado por LLM represente de fato a tarefa descrita em linguagem natural. O trabalho propõe checagem semântica contra referência e reparo iterativo, e aponta o PDDL 2.1 como o ponto mais frágil.

Por Redação Mapa Paper11 set
Era by Eon cria benchmark com empresa fictícia para testar agentes de IA

Era by Eon cria benchmark com empresa fictícia para testar agentes de IA

O Era by Eon Benchmark gera empresas fictícias completas, com simuladores de Salesforce, Zendesk, Slack e Gong, para avaliar agentes de IA com gabarito exato. Em 23 companhias simuladas, o realismo médio subiu de 61,8 para 97,0, e a acurácia dos nove modelos testados variou de 42,4% a 76,8%.

Por Redação Mapa Paper11 set
UnitBoost troca meta-agente LLM por operador de merge

UnitBoost troca meta-agente LLM por operador de merge

O UnitBoost substitui o meta-agente generativo de sistemas LLM compostos por um operador de merge definido, livre de ordem e com proveniência de unidade. Em três benchmarks held-out, supera o melhor candidato com rótulos gold em 0,060 a 0,195 ponto e eleva o F1 de célula do FanOutQA de 0,4778 para 0,5524.

Por Redação Mapa Paper11 set
LexAgentHallu: benchmark mede alucinações de agentes jurídicos de IA

LexAgentHallu: benchmark mede alucinações de agentes jurídicos de IA

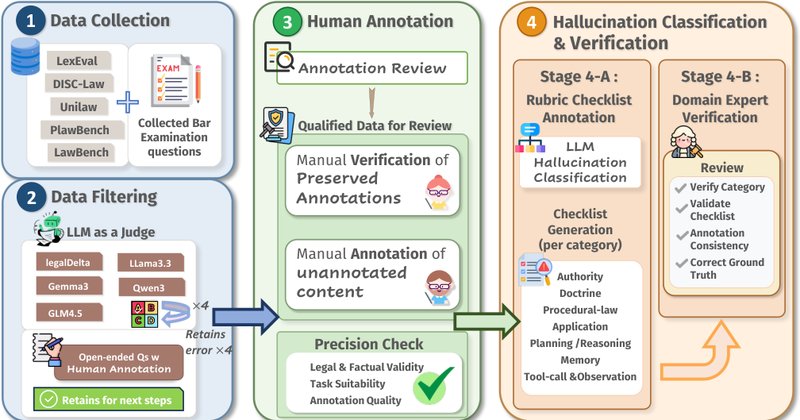
O LexAgentHallu, benchmark publicado no arXiv, avaliou 18 agentes jurídicos de IA em 3.414 instâncias e encontrou um efeito de resposta certa com raciocínio errado. As alucinações se agrupam em perfis previsíveis por framework, tarefa e categoria jurídica.

Por Redação Mapa Paper11 set
Estudo aponta falha em destilação multi-professor por correção

Estudo aponta falha em destilação multi-professor por correção

Estudo no arXiv analisou destilação multi-professor com filtro de correção e encontrou acurácia maior, mas recall zero em categoria Refuted e perda de funcionalidade de rótulos. O ganho real sobre filtro rígido não foi demonstrado.

Por Redação Mapa Paper11 set