
正确不等于受治理:代理工作流中的溯源完整性
Estudo do arXiv propõe camada Matrix para tornar agentes de IA auditáveis, mas revela risco de bloqueio excessivo em transferências entre contextos.
Estudo do arXiv propõe camada Matrix para tornar agentes de IA auditáveis, mas revela risco de bloqueio excessivo em transferências entre contextos.
Estudo no arXiv mostra que Estratégias de Evolução (ES) superam Reinforcement Learning (RL) em cobertura de soluções para LLMs, melhorando pass@k e desempenho em matemática. A técnica pode ser alternativa viável para pós-treinamento em domínios de descoberta.
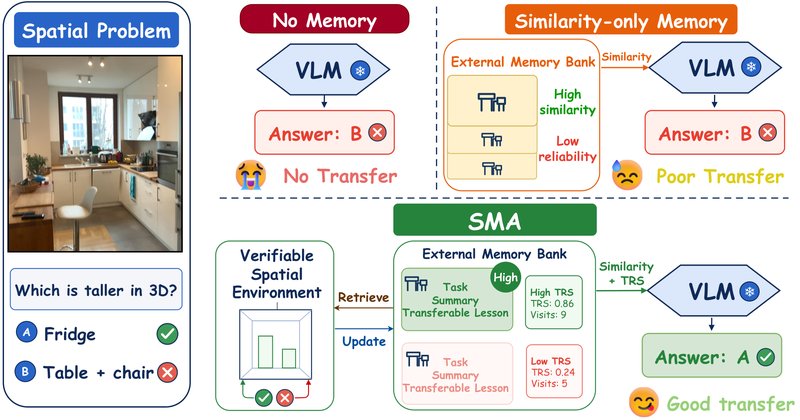
Pesquisadores apresentaram o Spatial Memory Agent (SMA), um framework que permite a VLMs congelados melhorar raciocínio espacial sem re-treino nem ferramentas externas, alcançando a melhor acurácia na maioria das 20 avaliações em cinco benchmarks.
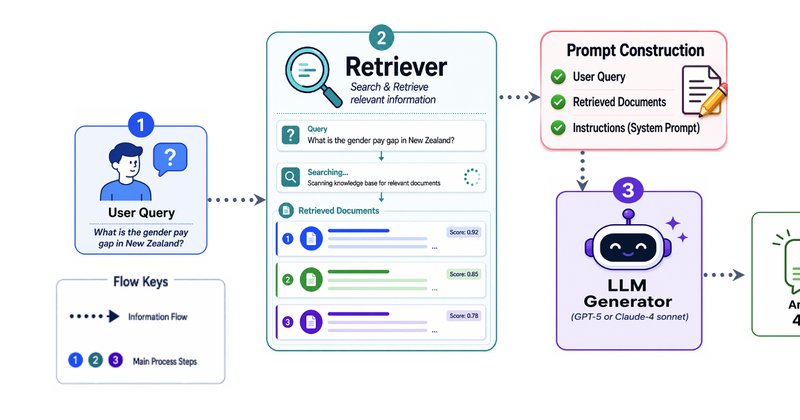
Pesquisadores apresentam o SEAG, framework que substitui entidades sensíveis por aliases em pipelines RAG, permitindo uso de LLMs externos sem expor dados confidenciais. Modelos atingiram mais de 80% de precisão na métrica User.
Um modelo de visão-linguagem que combina YOLO e CLIP alcançou 98,54% de acurácia ao classificar mosquitos infectados com dengue a partir de vídeos.
Framework multi-agente com LLMs automatiza taxonomia de preços em varejo, alcançando F1 0,83 e precisão acima de 90% em alimentos. Publicado no arXiv em agosto de 2026.
Estudo do arXiv propõe pipeline de IA que transforma tickets de ITSM em insights executivos, com avaliação positiva de stakeholders.
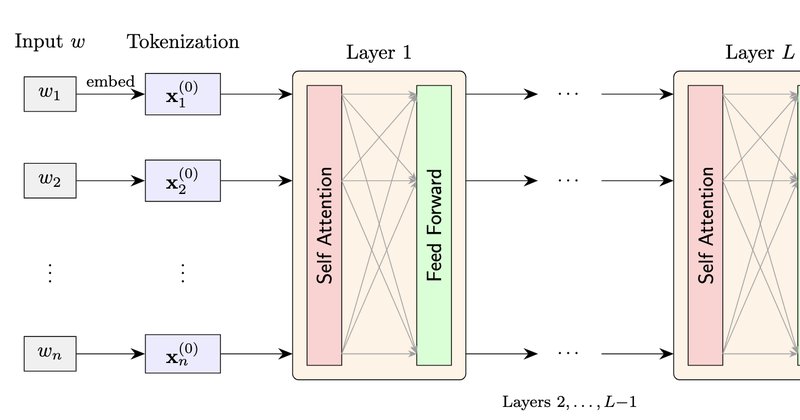
Pesquisa do arXiv usa complexidade de circuitos para mapear os limites dos transformers, arquitetura central dos LLMs. O estudo compara recursos como atenção e precisão com circuitos lógicos clássicos.
Estudo no arXiv deriva limites mais apertados para probabilidades de causalidade em cenários multivalorados, usando conhecimento causal de covariáveis e mediadores. O método estende trabalhos de Tian e Pearl e pode melhorar a precisão de modelos de IA.
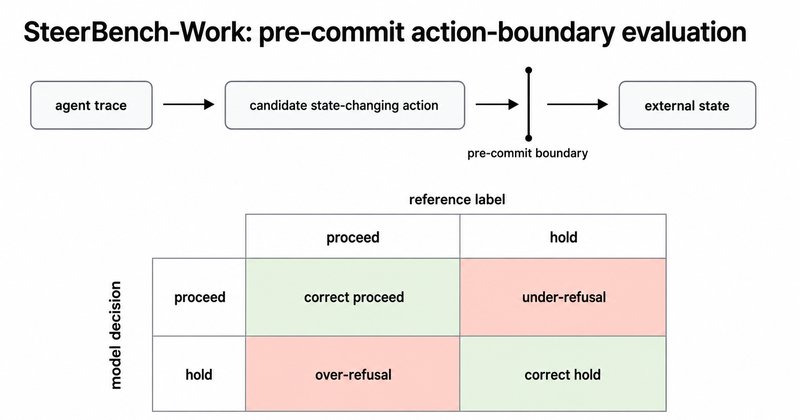
Benchmark SteerBench-Work revela que agentes de IA seguram indevidamente 28,1% do trabalho autorizado, enquanto permitem apenas 1,0% de ações inseguras. Estudo aponta que capacidade geral não garante calibração de decisões.