
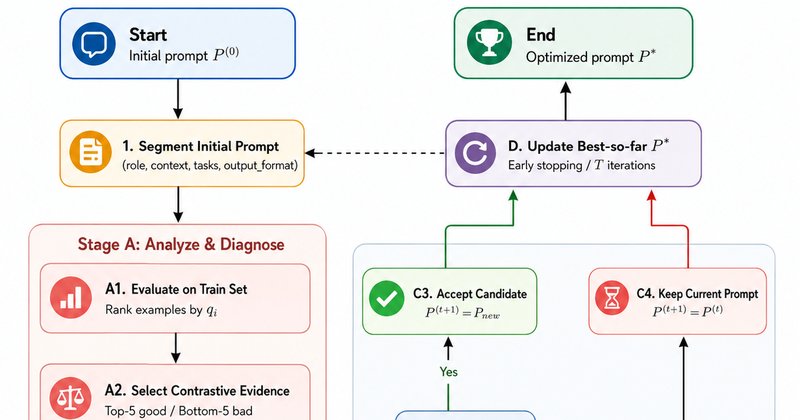
SAPO: otimização de prompts por segmentos supera métodos monolíticos
Pesquisa no arXiv apresenta o SAPO, método de otimização de prompts por segmentos que supera baselines como APE e OPRO em cinco benchmarks com modelos da OpenAI.
Pesquisa no arXiv apresenta o SAPO, método de otimização de prompts por segmentos que supera baselines como APE e OPRO em cinco benchmarks com modelos da OpenAI.
Pesquisadores instrumentaram treino com RL (GRPO) e treinaram um meta-controlador PPO que ajusta a geração de tokens à potência medida. Em GPUs A100, as violações de limite de energia caíram até 89,8%, com ganho de 18,1% na produção de tokens na escala de 7B.
Pesquisadores propõem um framework para avaliar clones de personalidade de IA com base na indiscernibilidade observável, e não em debates sobre consciência. O estudo também define o conceito de 'delegado', um clone parcial de vida limitada.
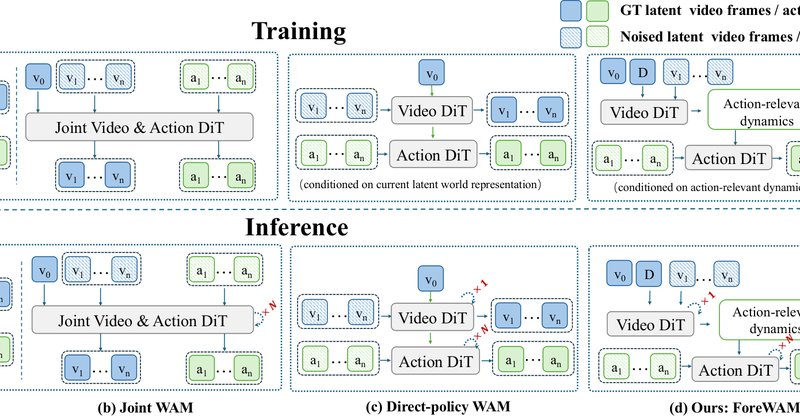
Pesquisadores apresentam o ForeWAM, um World Action Model que guia ações robóticas com estados futuros latentes, sem gerar vídeo — com até 96,9% de sucesso no benchmark LIBERO.
Pesquisadores lançam o MBA-Bench, descrito como o primeiro benchmark multimodal para agentes de geração de ideias de negócio. Os modelos propostos superam linhas de base multimodais em até 35,8%.
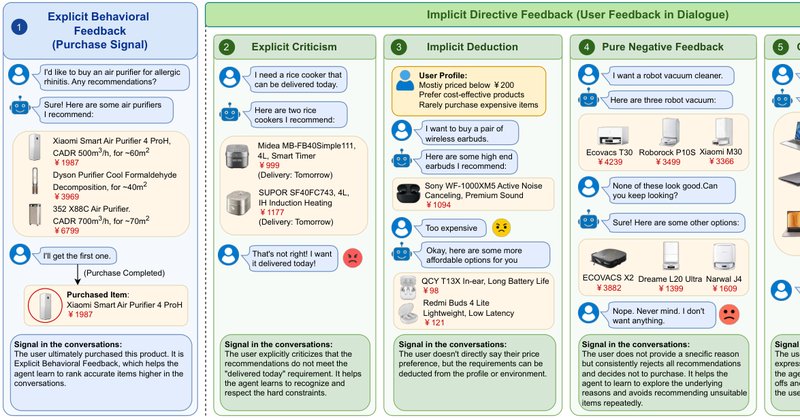
Pesquisadores propõem o LOFA, framework que permite a agentes de compra baseados em LLMs aprenderem com feedback real de usuários em conversas de e-commerce, sem anotação humana. Em testes com logs reais, o método melhorou a qualidade das recomendações e o alinhamento com a satisfação do usuário.
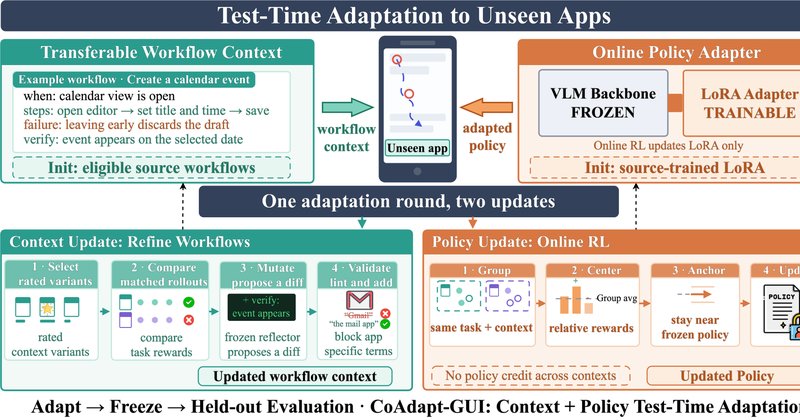
O framework CoAdapt-GUI adapta agentes de GUI mobile a aplicativos nunca vistos no treinamento. No AndroidWorld Plus, o desempenho subiu de 38,6% para 52,9%.
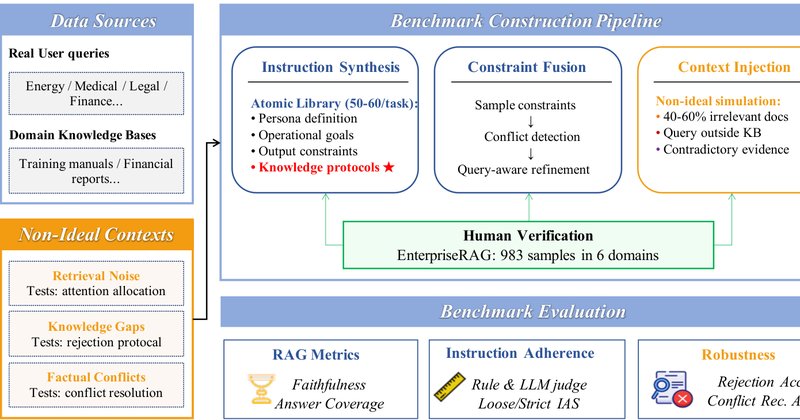
Novo benchmark com 983 casos avalia 13 LLMs em RAG empresarial e revela que as respostas cumprem 80% das exigências isoladas, mas só 26,8% atendem a todos os requisitos simultaneamente.
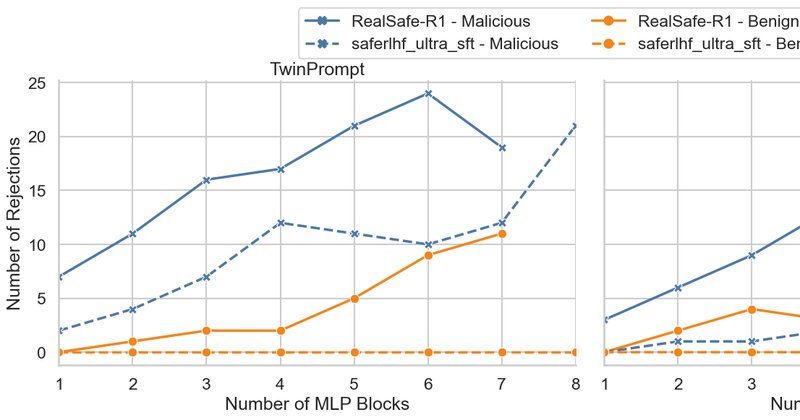
Estudo no arXiv localiza o comportamento de recusa de LLMs nas camadas MLP do meio da rede; pesos dessas camadas transferem recusa a prompts maliciosos com ao menos 2,7 vezes mais eficácia que atenção.
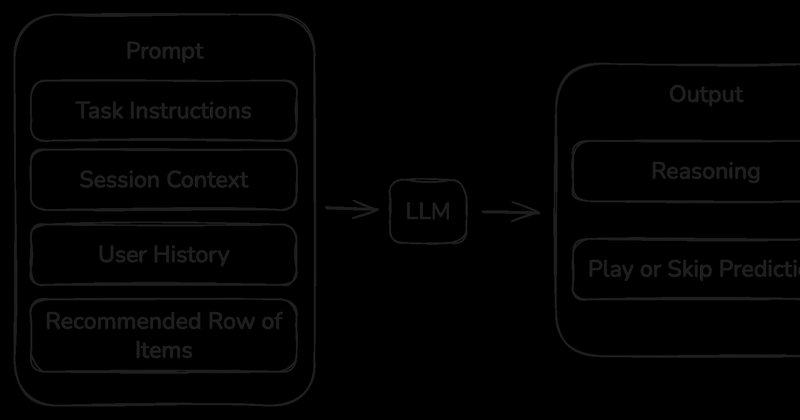
Pesquisa no arXiv mostra que LLMs usados como avaliadores de recomendação produzem argumentos convincentes para conclusões opostas sobre o mesmo item. Alinhamento comportamental elevou o Macro-F1 em 32,19% e igualou o baseline de produção.