
Agentes de IA em terminais: survey propõe perfil de 7 dimensões
Estudo publicado no arXiv em agosto de 2026 unifica pesquisas dispersas sobre uso de linha de comando por modelos de linguagem
O que aconteceu
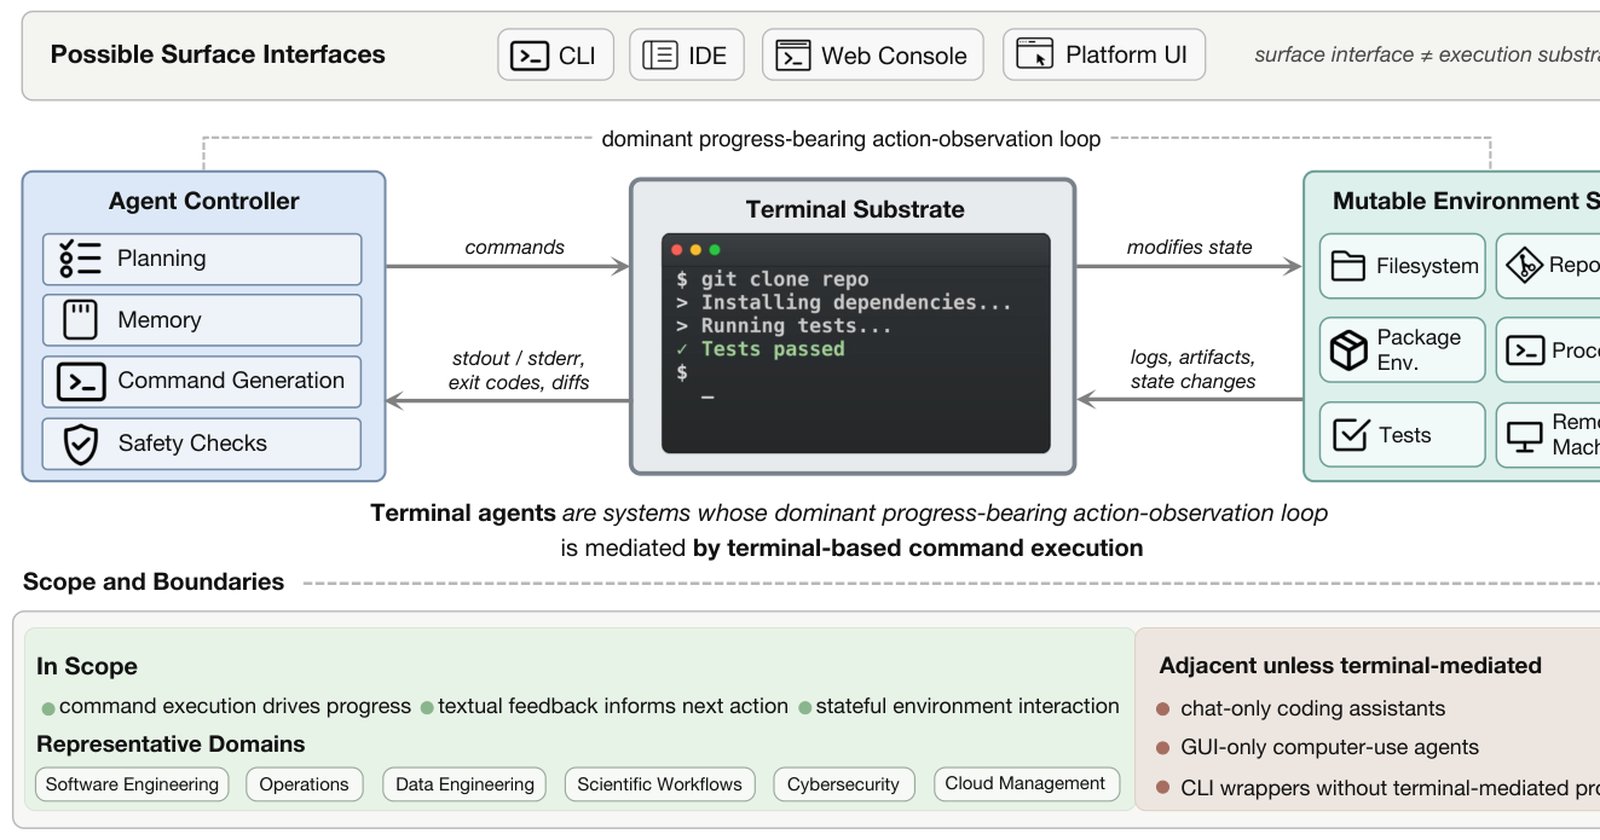
O arXiv publicou o survey 'Terminal Agents: A Survey of AI Agents in Command-Line Environments' em 20 de agosto de 2026, identificado como arXiv:2608.20485. O trabalho reúne pesquisas dispersas em engenharia de software, uso de ferramentas e interação com computador, propondo um olhar unificado sobre agentes que agem por meio de terminais. Em vez de tratar o terminal como um detalhe, o survey o coloca no centro: a execução de comandos, o feedback textual e a interação com ambientes com estado formam o loop principal de ação e observação.
O estudo estabelece um perfil de competência composto por sete dimensões. Ele descreve como o comportamento dos agentes é moldado por cinco fatores: modelo, interface, harness, runtime e ambiente. Os pesquisadores argumentam que a avaliação predominante foca apenas nos resultados finais, deixando de lado a qualidade do processo, a recuperação de erros e a governança.
Contexto
A pesquisa sobre agentes de IA em terminais sempre foi fragmentada. Trabalhos anteriores tratavam do tema de forma isolada em três áreas: engenharia de software, uso de ferramentas e interação com computador. Essa dispersão dificultava comparar resultados e entender o que realmente leva um agente a ter bom desempenho. O survey surge para preencher essa lacuna, usando a execução mediada por terminal como lente organizadora.
O contexto também inclui a expansão dos modelos de linguagem de grande escala. Cada vez mais, esses modelos operam em ambientes de linha de comando, automatizando tarefas de programação, administração de sistemas e análise de dados. A falta de um framework comum tornava difícil avaliar se um agente é confiável, recuperável e transparente.
Por que importa
A avaliação de agentes de IA em terminais tem impacto direto em quem desenvolve e implanta essas ferramentas. Se as métricas atuais ignoram recuperação de erros e governança, um agente pode parecer eficiente em testes, mas falhar em produção quando encontra situações inesperadas. O survey mostra que famílias de benchmarks expõem sinais de processo diferentes, e comparações entre sistemas revelam desempenho dependente do benchmark.
Para empresas que usam agentes em pipelines de software, isso significa que escolher um modelo baseado apenas em acurácia de tarefa pode ser enganoso. A proposta de reportar explicitamente condições de sistema e runtime, com rastros reproduzíveis e evidências de nível de processo, oferece um caminho para avaliações mais honestas.
Impacto
O trabalho demonstra que diagnósticos de condição fixa têm duas implicações práticas. Primeiro, benchmarks diferentes não medem as mesmas capacidades. Um agente pode se destacar em um conjunto de testes e fracassar em outro, mesmo com tarefas aparentemente semelhantes. Segundo, a atribuição de componentes é limitada: não é trivial dizer se o bom desempenho vem do modelo, da interface ou do harness.
Essas descobertas afetam tanto a pesquisa acadêmica quanto o desenvolvimento comercial. Para pesquisadores, o survey sugere que a publicação de resultados deve incluir detalhes de runtime e rastros executáveis. Para a indústria, isso pode mudar a forma como comparam produtos concorrentes de agentes de linha de comando.
O que muda
A principal mudança proposta é a adoção de um perfil de competência de sete dimensões como padrão para estudar agentes mediados por terminal. O estudo também recomenda que as avaliações passem a registrar condições de sistema e runtime, além de fornecer rastros reproduzíveis. Isso permitiria que outros reproduzissem experimentos e comparassem resultados com mais precisão.
além disso, o survey sugere que a qualidade do processo deve ser considerada junto com o resultado final. Métricas como capacidade de recuperação após erro e governança das ações executadas precisam entrar no cálculo de desempenho, em vez de ficarem de fora.
O que vem agora
O framework apresentado no survey fornece uma base unificada para pesquisas futuras em engenharia de software e domínios emergentes. Como o trabalho é recente, a expectativa é que ele inspire novas linhas de investigação, especialmente no desenvolvimento de benchmarks que meçam processo, recuperação e governança. Os pesquisadores também podem usar as sete dimensões para criar sistemas de avaliação mais robustos.
O próximo passo natural é a aplicação prática do perfil em diferentes cenários, como agentes de CLI para DevOps, automação de testes e análise de dados. O survey não apresenta resultados experimentais próprios, mas oferece um mapa para quem quiser comparar agentes de forma mais rigorosa. A comunidade de IA pode adotar essas diretrizes em novas publicações, tornando o campo mais transparente e comparável.