
BenchBench-Protocol: benchmark testa LLMs em protocolos de laboratório real
Benchmark com 149 tarefas reais de modificação de protocolos avalia modelos de linguagem em tarefas de laboratório molhado.
O que aconteceu
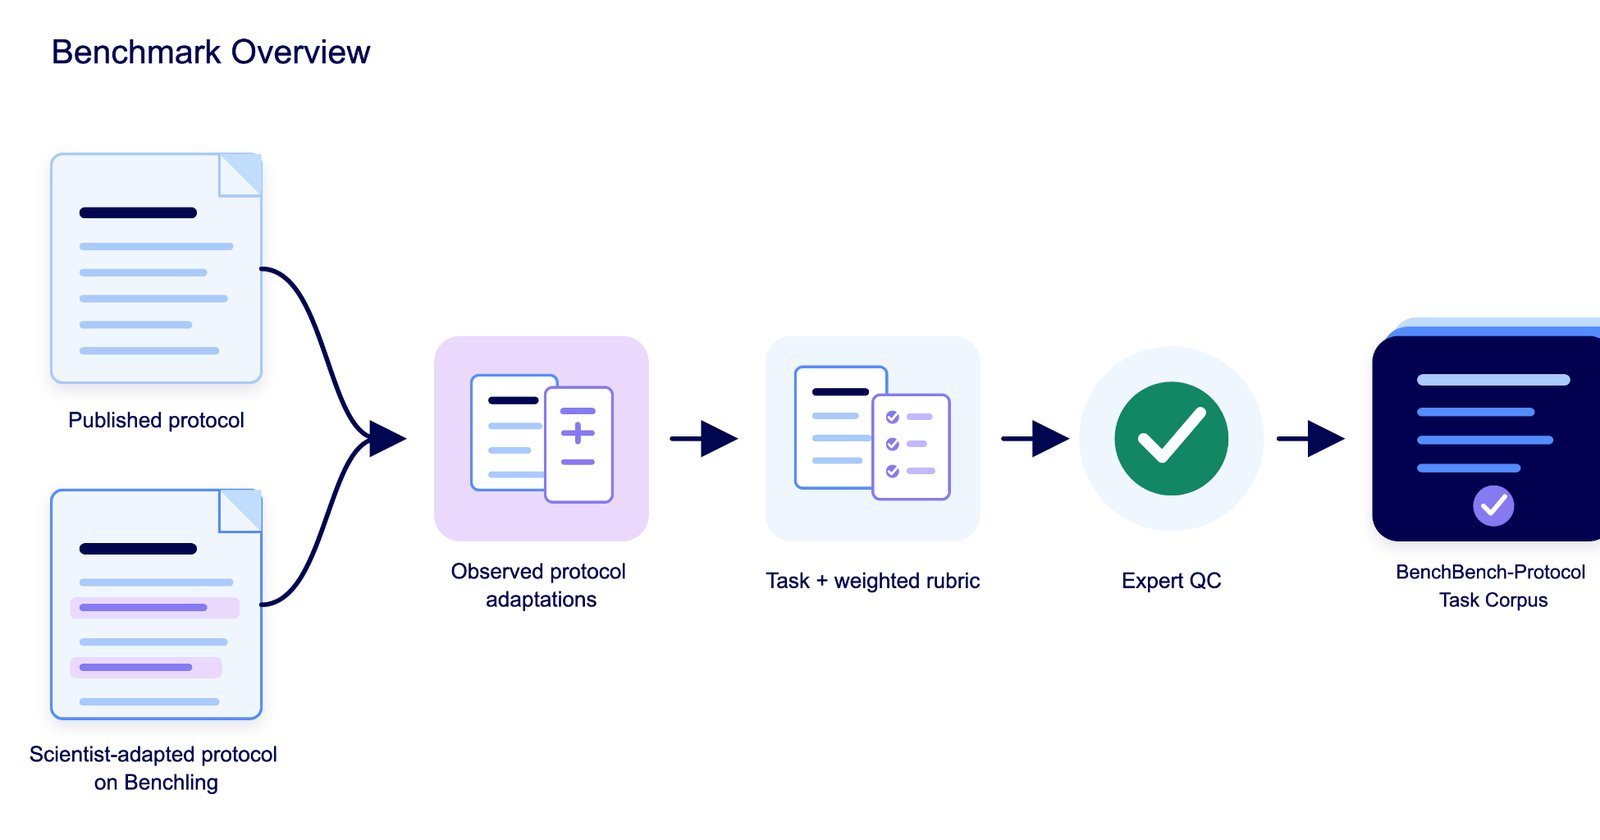
O BenchBench-Protocol foi submetido à arXiv em 24 de agosto de 2026 como arXiv:2608.23898v1. O benchmark contém 149 tarefas de modificação de protocolos recuperadas de modificações que cientistas fizeram em protocolos publicados durante trabalhos experimentais reais. As tarefas são derivadas das diferenças entre protocolos publicados e versões modificadas por cientistas, fornececendo a base para as consultas e elementos de rubrica ponderados para respostas corretas. O benchmark extrai tarefas de 96 protocolos-fonte distribuídos em nove domínios de biologia de laboratório molhado. Apenas tarefas classificadas como altas após revisão por especialistas em domínio foram incluídas.
Contexto
Adaptar um protocolo publicado para uma nova experiência é uma tarefa rotineira para cientistas de laboratório molhado. Uma modificação correta exige considerar escolhas anteriores e etapas subsequentes. Benchmarks recentes em ciências da vida migraram para tarefas abertas, classificadas por rubricas, mas são tipicamente elicidados de especialistas em vez de reconstruídos a partir de modificações reais. O BenchBench-Protocol se diferencia ao derivar tarefas diretamente de diferenças entre protocolos publicados e versões modificadas por cientistas.
Por que importa
Como modelos de linguagem se tornam cada vez mais úteis na pesquisa de ciências da vida, avaliá-los em tarefas rotineiras de laboratório molhado torna-se cada vez mais importante. O BenchBench-Protocol fornece uma avaliação fundamentada do raciocínio em laboratório molhado e evidências da utilidade de experimentos reais para construir tarefas de benchmark.
Impacto
Nove modelos fechados e abertos foram avaliados. Claude Opus 5 obteve a maior pontuação com 59,2% de pontuação normalizada na rubrica. Outros modelos ficaram entre 34,1% e 47,1%. O benchmark permanece não saturado mesmo considerando a melhor de dez tentativas. O fato de o benchmark não atingir 100% de acerto, mesmo com múltiplas tentativas, demonstra a complexidade real dessas tarefas.
O que muda
O BenchBench-Protocol introduz uma abordagem baseada em evidências reais para avaliar modelos de linguagem em tarefas de laboratório. A construção de tarefas a partir de modificações reais, em vez de elicitação de especialistas, oferece uma avaliação mais precisa do desempenho prático dos modelos.
O que vem agora
Com o benchmark não saturado, os pesquisadores podem usar o BenchBench-Protocol para avaliar continuamente novos modelos. A utilidade de experimentos reais para construir tarefas de benchmark sugere que futuros benchmarks seguirão essa abordagem. O fato de Claude Opus 5 liderar com 59,2% indica que há margem significativa para melhoria nos modelos atuais.