
ComponentBench: benchmark diagnostica falhas de agentes de IA em UIs web
Pesquisa com 2.910 tarefas mostra que a escolha do espaço de observação e ação pode mudar o desempenho em mais de 30% para o mesmo modelo.
O que aconteceu
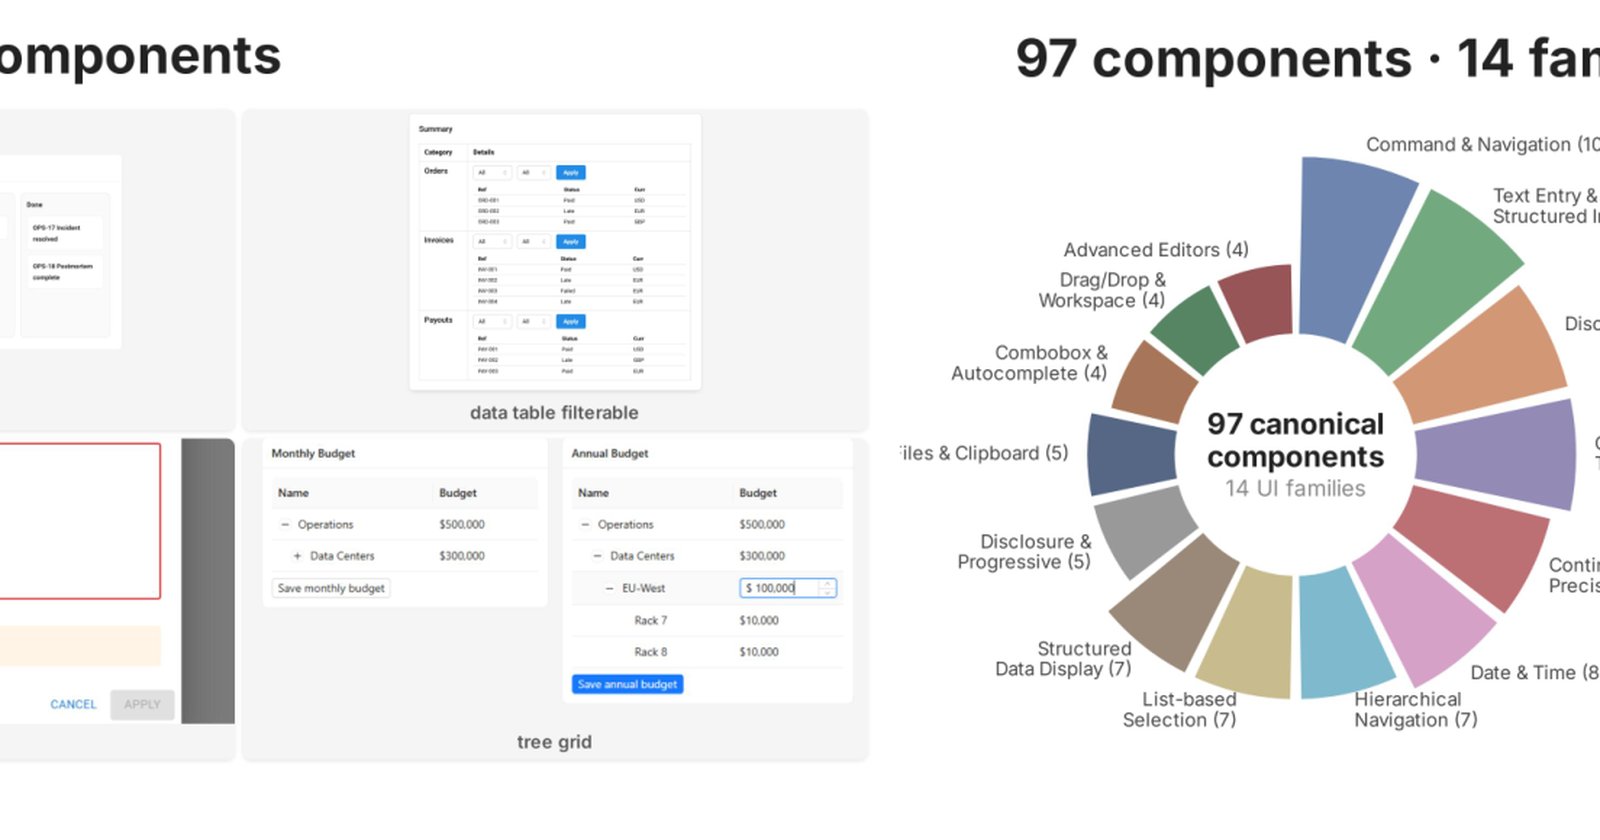
Pesquisadores publicaram no arXiv (2608.18307) o ComponentBench, um benchmark e pipeline de diagnóstico para avaliar agentes de uso de computador em componentes de interface web modernos. O conjunto é organizado em uma ontologia de 97 componentes canônicos de UI, instanciados em 2.910 tarefas verificadas programaticamente, com trajetórias humanas de referência limpas para medir sucesso e eficiência de interação.
Foram avaliados sete modelos — GPT-5.4, Gemini 3 Flash, GPT-5.4 mini, GPT-5 mini, Gemini 3.1 Flash-Lite, Qwen3-VL-235B e UI-TARS-1.5-7B — em quatro espaços de observação e ação. O estudo revelou que, dentro de um mesmo harness, a troca apenas do espaço de observação e ação muda o sucesso da tarefa em mais de 30% para o mesmo modelo. O caso mais extremo: GPT-5 mini cai de 83,1% com observações por árvore de acessibilidade para 48,9% com controle de Pixel apenas por coordenadas.
Contexto
A avaliação de agentes de uso de computador sempre foi dividida entre benchmarks de workflow de longo horizonte e testes atômicos de grounding em GUI. Essa divisão deixava uma camada intermediária pouco instrumentada: interações realistas centradas em componentes, como alternar um conjunto de botões, que são curtas o suficiente para diagnosticar e ricas o suficiente para capturar os desafios das interfaces modernas. O ComponentBench preenche essa lacuna, oferecendo um padrão agnóstico de biblioteca para medir falhas em nível de componente.
Por que importa
Para empresas que desenvolvem agentes de IA, o resultado é um alerta prático: a escolha da interface de observação e ação não é um detalhe técnico, mas um fator que pode dobrar a taxa de erro. Um agente que funciona bem com árvore de acessibilidade pode falhar sistematicamente quando opera apenas com pixels, o que afeta diretamente o design de produtos que dependem de automação de navegador. Além disso, a eficiência ainda está longe da humana — mesmo a configuração mais rápida leva 3,7 vezes mais tempo que a referência humana, e manipulações espaciais triviais para pessoas continuam desafiadoras para os agentes.
Impacto
No curto prazo, o ComponentBench oferece uma ferramenta concreta para desenvolvedores diagnosticarem falhas em componentes específicos e famílias de componentes, com um pipeline escalável para auditar dificuldade estrutural e sintetizar análises de falha. No médio prazo, o benchmark pode orientar melhorias em modelos e na forma como os agentes percebem e agem no mundo digital, especialmente em tarefas que exigem precisão espacial.
O que muda
A avaliação de agentes de uso de computador ganha um nível intermediário de granularidade, permitindo que equipes de engenharia isolem problemas em componentes de UI antes de testar fluxos completos. Isso muda a prática de desenvolvimento, que hoje depende de métricas agregadas ou testes atômicos isolados, para uma abordagem mais diagnóstica e acionável.
O que vem agora
Os autores não detalham próximos passos no resumo, mas o pipeline de diagnóstico é apresentado como escalável, o que sugere expansão para mais bibliotecas de componentes e cenários. A comunidade de IA pode adotar o ComponentBench como referência para comparar agentes em tarefas de componente, e é provável que novos modelos sejam testados contra esse padrão nos próximos meses.
Fonte: arXiv — https://arxiv.org/abs/2608.18307