
FedV-KGQA propõe respostas em grafos de conhecimento federados
Estudo no arXiv traz três resultados experimentais e quatro lições de design para perguntas multi-hop em grafos particionados
O que aconteceu
O FedV-KGQA in Practice: Design Lessons and an Interactive Prototype chegou ao arXiv em 12 de setembro de 2026, com o identificador arXiv:2609.13661v1, na categoria cs.AI. O autor registrado na submissão é Md Saikat Islam Khan Bappy. O formato é de pôster, ou seja, um texto curto de conferência, e o arquivo enviado tem 585 KB.
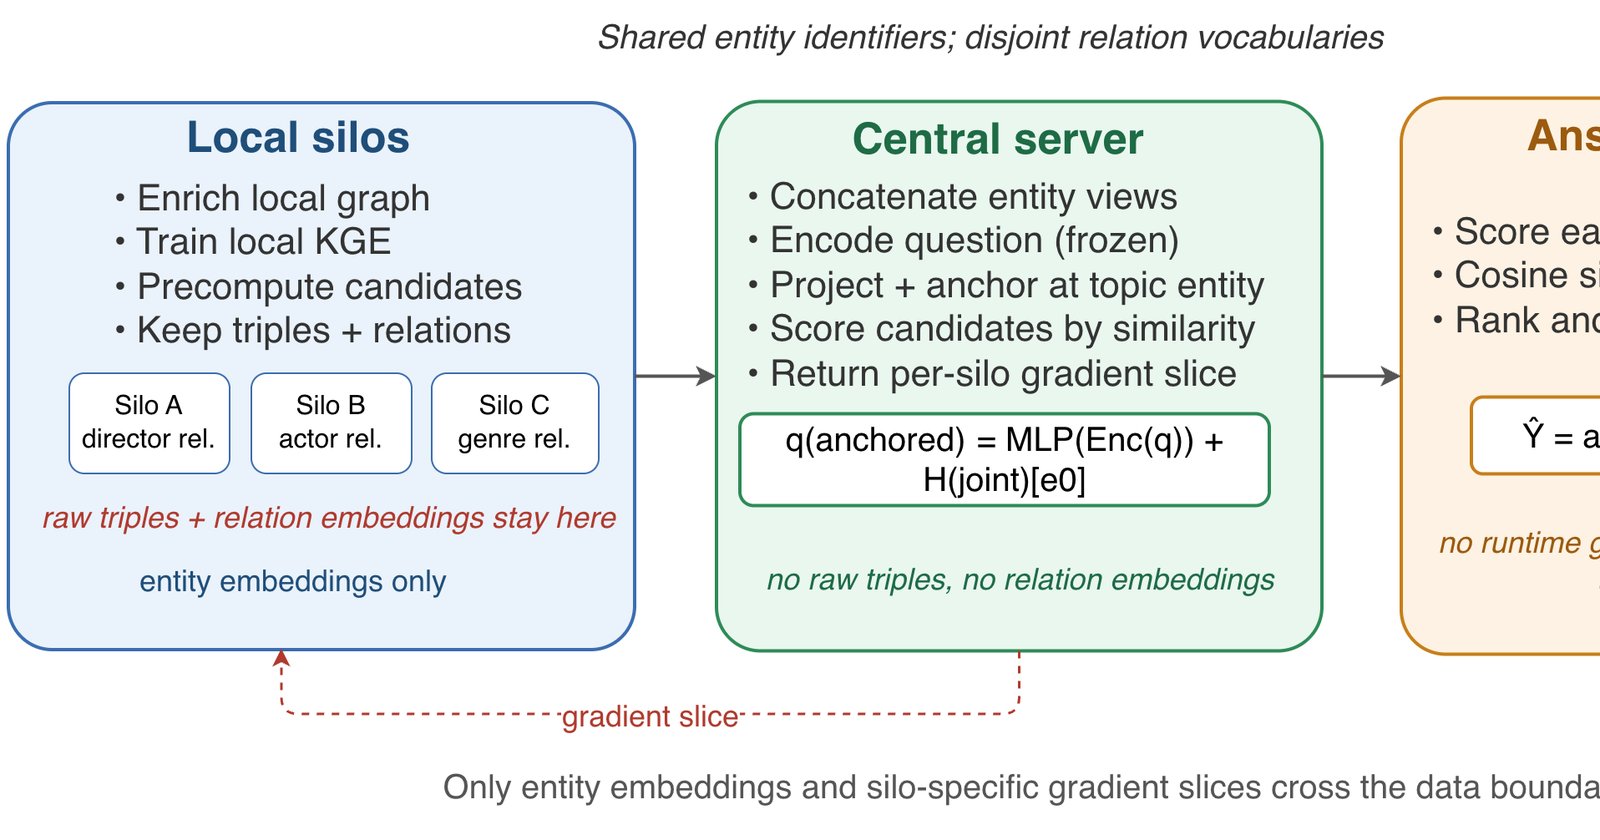
O FedV-KGQA é um método para responder perguntas de múltiplos saltos (multi-hop) quando o grafo de conhecimento está dividido entre organizações. No arranjo descrito, cada silo enriquece seu grafo local e treina um embedding de grafo de conhecimento apenas sobre as triplas que possui. Um servidor então concatena as visões de entidade específicas de cada silo, ancora a pergunta projetada na entidade tópico e ordena os candidatos por similaridade. Triplas brutas e embeddings de relação nunca saem do silo.
A comparação cruzada entre os experimentos do FedV-KGQA rende três resultados. O primeiro: a fusão federada recupera a maior parte da precisão centralizada, enquanto um único silo recupera pouco. O segundo: ancoragem e enriquecimento importam mais do que a escolha do modelo de embedding. O terceiro: o encoder mais barato depende da acurácia-alvo, não da contagem de parâmetros.
O artigo contribui com essa comparação entre experimentos, com quatro lições de design extraídas dela e com um protótipo interativo que roda inferência real e traça o pipeline completo, pergunta por pergunta, sobre checkpoints já liberados.
Contexto
A resposta a perguntas sobre grafos de conhecimento (KGQA, na sigla em inglês) costuma partir de uma premissa simples: um único sistema alcança o grafo inteiro. O resumo do artigo diz que isso raramente se sustenta na prática.
Na prática descrita pelo FedV-KGQA, os fatos ficam com organizações que compartilham identificadores de entidade, mas possuem tipos de relação disjuntos. O resultado é que nenhuma das partes enxerga uma cadeia de raciocínio completa. Esse é o cenário de particionamento vertical: os dados não estão divididos por exemplos, e sim por colunas de relação, cada uma sob o controle de um dono diferente.
O problema fica mais difícil quando a pergunta exige vários saltos. Para chegar à resposta, o sistema precisa encadear relações que estão em silos distintos, sem que nenhum silo veja o encadeamento todo. A alternativa óbvia, reunir tudo em um servidor central, esbarra no motivo pelo qual os dados estão separados desde o começo.
Por que importa
A contribuição prática do FedV-KGQA é mostrar que existe um caminho intermediário. A fusão federada, segundo os experimentos comparados no pôster, chega perto da precisão de um sistema que vê o grafo inteiro. Um silo isolado, por outro lado, não chega perto. Isso significa que o ganho não vem de ter dados maiores em um único ponto, e sim de combinar visões parciais.
O segundo resultado tem consequência direta para quem projeta esses sistemas. Ancoragem da pergunta na entidade tópico e enriquecimento do grafo local pesam mais no resultado final do que a escolha do modelo de embedding. Em outras palavras, o trabalho de engenharia em torno da pergunta e do grafo rende mais do que trocar a arquitetura de representação.
Impacto
O terceiro resultado ataca uma intuição comum em projetos de IA. O encoder mais barato não é o de menos parâmetros, e sim o que atende à acurácia que o sistema precisa entregar. A decisão de custo passa a depender do alvo, não do tamanho do modelo. Para quem opera com orçamento limitado, isso muda a ordem das escolhas: primeiro definir a acurácia aceitável, depois escolher o encoder.
O FedV-KGQA também impõe uma restrição de privacidade desde o desenho. Triplas brutas e embeddings de relação nunca deixam o silo. O que circula é a visão de entidade concatenada pelo servidor. Para organizações que não podem expor os fatos que detêm, esse é o ponto central do método.
O que muda
O pôster não fica na descrição conceitual. Ele entrega um protótipo interativo que executa inferência real e mostra o caminho completo de cada pergunta, sobre checkpoints liberados. Isso permite inspecionar onde o sistema acerta e onde erra, em vez de confiar apenas em métricas agregadas.
As quatro lições de design reunidas no artigo são o resumo operacional da comparação. Elas existem porque o FedV-KGQA foi comparado com ele mesmo em configurações diferentes, e não apenas contra uma linha de base externa. O material não detalha o conteúdo das quatro lições além do que os três resultados indicam.
O que vem agora
O texto é um pôster, formato típico de apresentação em conferência, e foi submetido ao arXiv em 12 de setembro de 2026. O material disponível não informa em qual evento o trabalho será apresentado nem prazos de publicação.
O caminho imediato está nos checkpoints liberados e no protótipo interativo. Eles permitem que outros grupos reproduzam a inferência e testem as lições de design em grafos verticalmente particionados com características próprias.
Fontes
- arXiv cs.AI: FedV-KGQA in Practice: Design Lessons and an Interactive Prototype (https://arxiv.org/abs/2609.13661)