
LLMs acertam até 81,67% em revisão de literatura sobre doenças
Pesquisa do arXiv compara automação com revisão manual e aponta onde a IA ainda erra
O que aconteceu
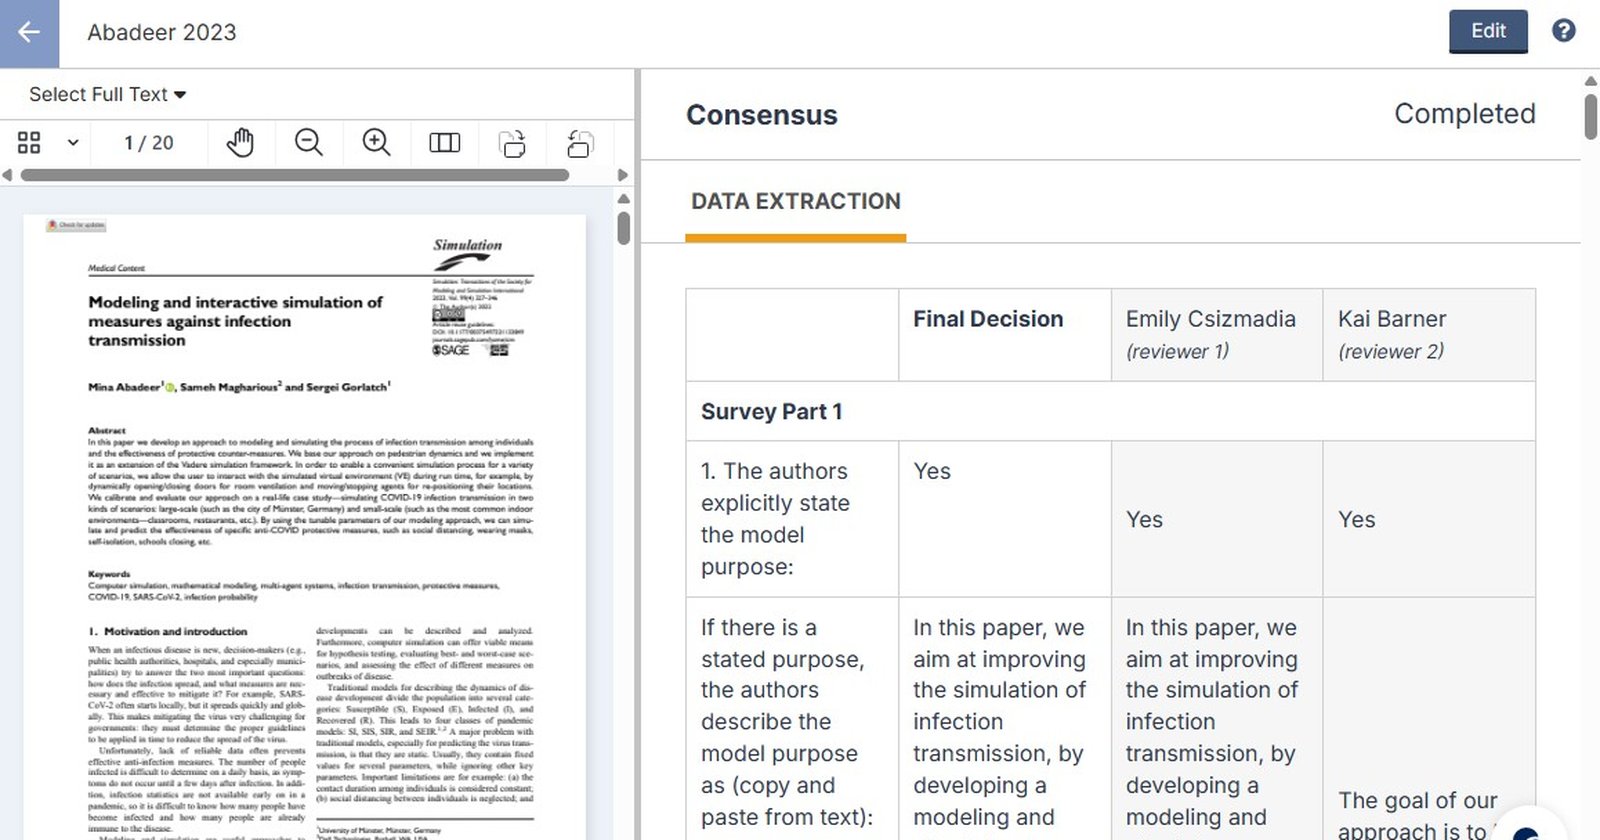
O estudo arXiv:2608.26150, submetido em 1º de julho de 2026 na categoria cs.AI, documenta o desenvolvimento de um pipeline de grandes modelos de linguagem para extrair informações relevantes de 536 artigos revisados por pares sobre modelagem baseada em agentes aplicada à propagação de doenças. Esse conjunto de 536 papers, todos revisados por pares, foi processado pelo pipeline baseado em LLMs, que incluiu o GPT-4.1 e o GPT-5.0. Os resultados, reportados no resumo do paper, mostram que o GPT-4.1 alcançou precisão de 77,95% em nível de artigo, enquanto o GPT-5.0 chegou a 81,67%. Esses percentuais, de 77,95% e 81,67%, respectivamente, foram medidos na comparação com uma revisão sistemática de literatura (SLR) conduzida manualmente por humanos.
Em nível de campo, a precisão variou de 32,40% a 100%, com campos mais complexos ou subjetivos apresentando desempenho menos confiável. A variação, que vai de 32,40% até 100% conforme o campo, mostrou que itens como avaliação de qualidade metodológica são os mais frágeis. Os pesquisadores também encontraram um padrão relevante: a concordância entre os dois modelos pode funcionar como indicador de qualidade. Quando o GPT-4.1 e o GPT-5.0 divergem, há sinal de possível alucinação. Como indicador de qualidade, a concordância entre LLMs foi apontada como útil, com alta concordância e baixa precisão apontando para erros nos dados humanos.
Contexto
Revisões sistemáticas de literatura são processos longos e caros, usados em áreas como epidemiologia para consolidar o estado da arte. Um pesquisador pode levar meses para ler, classificar e extrair dados de centenas de artigos. Com o avanço dos LLMs, a ideia de automatizar parte desse trabalho ganhou força. Este estudo é um dos primeiros a quantificar o desempenho de GPT-4.1 e GPT-5.0 em uma tarefa real de SLR, usando artigos reais revisados por pares como base. O material analisado, os 536 papers de modelagem baseada em agentes, representa um nicho específico, mas o pipeline pode ser adaptado para outras áreas.
A escolha de dois modelos da OpenAI, o GPT-4.1 e o GPT-5.0, permitiu comparar a evolução entre gerações. O GPT-5.0, lançado pela OpenAI, superou o GPT-4.1 na tarefa, com diferença de aproximadamente 3,72 pontos percentuais. Essa diferença, embora pequena, foi consistente, segundo os autores.
Por que importa
Para pesquisadores de modelagem de doenças, a automação da SLR pode reduzir o tempo de preparação de revisões de meses para dias. O pipeline permite varrer centenas de artigos em horas, com custo computacional relativamente baixo. No entanto, a precisão de 81,67% no melhor modelo significa que, em cerca de 1 em cada 5 artigos, alguma informação foi extraída incorretamente. Em campos subjetivos, como a avaliação de qualidade metodológica, a precisão caiu para 32,40%, o que torna indispensável a revisão humana nesses pontos.
O estudo também chama a atenção para a qualidade dos dados humanos. Em alguns campos, os dois LLMs concordaram entre si, mas erraram em relação à revisão manual. Isso sugere que a própria SLR humana pode conter erros, abrindo um debate sobre padrões de referência na área.
Impacto
No curto prazo, o estudo oferece à comunidade acadêmica um protocolo de prompts documentado e um conjunto de 536 artigos como referência. Outros grupos podem reproduzir o pipeline e testar em bases próprias. No médio prazo, a abordagem pode ser estendida para revisões em outras áreas da modelagem e da simulação, como redes de transporte ou economia. O uso da concordância entre modelos como métrica de qualidade também pode ser adotado em outras tarefas de extração de informação, não apenas em SLR.
Um impacto número a número: se uma SLR tradicional exige leitura de 500 artigos, com o pipeline o revisor pode focar apenas nos casos de baixa concordância, reduzindo o volume de leitura manual. O estudo não quantifica essa redução, mas a lógica de triagem por divergência é o principal ganho prático.
O que muda
O fluxo de trabalho de revisão de literatura muda de "ler tudo" para "ler o que os modelos discordam". O revisor deixa de ser o executor do processo e passa a ser o supervisor. Isso exige novas habilidades, como a capacidade de julgar quando o LLM está certo e quando o humano está errado, especialmente nos campos subjetivos. Para editores e periódicos, o estudo sinaliza que a IA pode ser usada como ferramenta de pré-triagem, com ciência de suas limitações.
O que vem agora
O paper está disponível como pré-print no arXiv desde 1º de julho de 2026, na categoria cs.AI. Os autores não indicam, no material publicado, planos de submissão a periódicos ou conferências, mas espera-se que o pipeline e os prompts sejam refinados para reduzir erros em campos subjetivos. A investigação sobre a concordância entre LLMs deve continuar, com foco em métricas para detecção de alucinação. Também é provável que versões futuras incorporem modelos maiores ou ajuste fino para tarefas específicas de revisão.