
LLMs não conseguem seguir muitas instruções ao mesmo tempo
Benchmark com 369 mil testes revela colapso na satisfação de restrições compostas
O que aconteceu
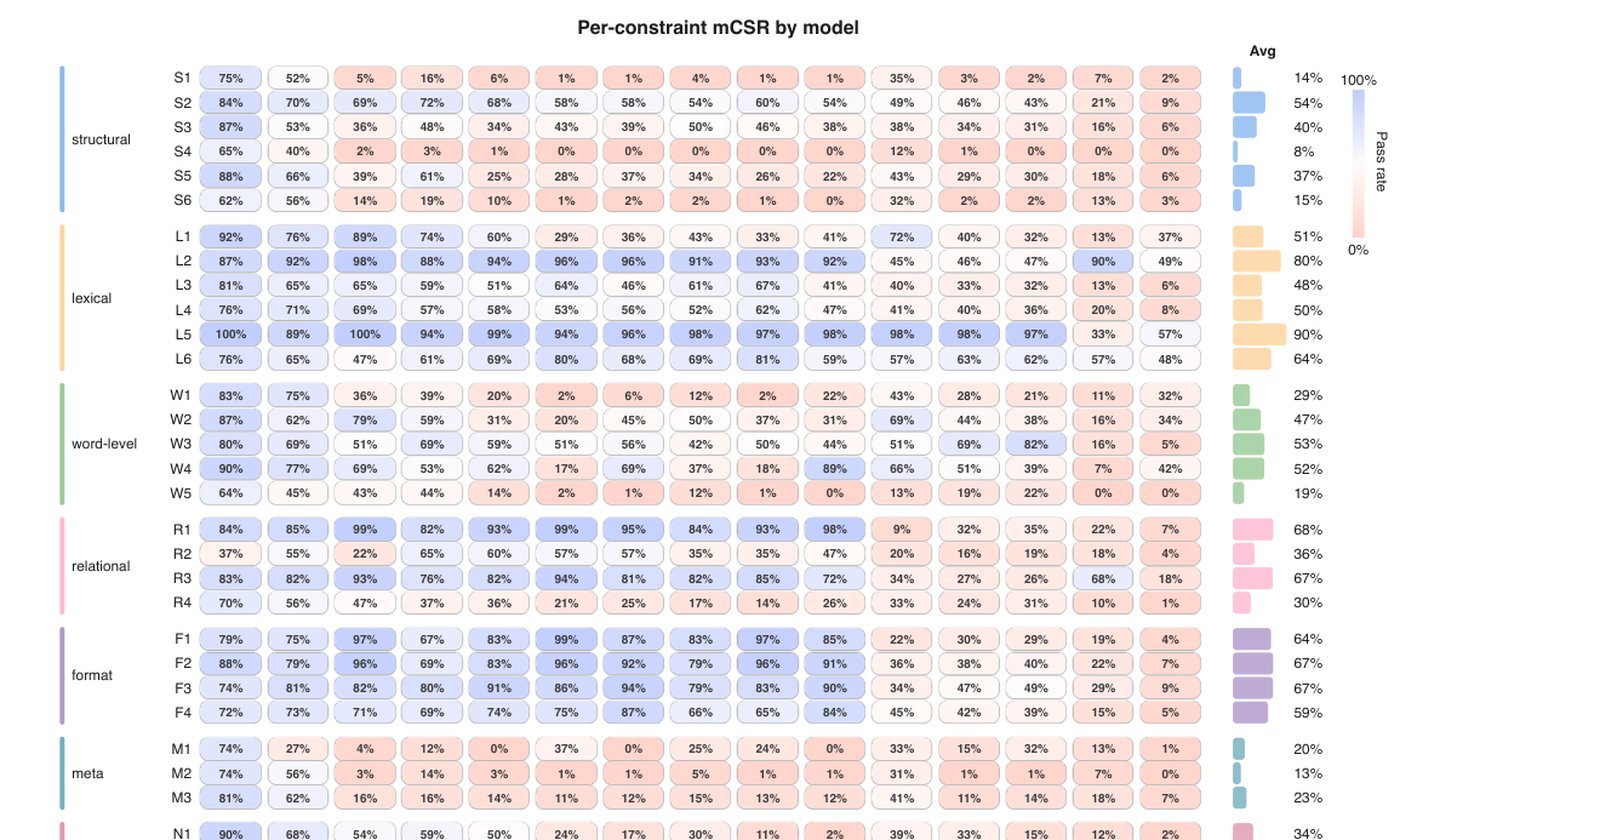
Um estudo submetido ao arXiv em 12 de agosto de 2026 (arXiv:2608.12426) apresenta o Constraint Saturation Evaluation (CSE), um benchmark procedural que mede a capacidade de modelos de linguagem de seguir múltiplas instruções simultâneas. Foram avaliados 15 modelos, 36 tipos de restrições e 369.753 verificações, com k variando de 1 a 12 restrições. Cada resposta foi validada por um verificador determinístico baseado em regras, sem uso de LLM como juiz.
Os resultados mostram uma transição de fase: enquanto a taxa de sucesso por restrição individual decai gradualmente, a probabilidade de satisfazer todas as restrições colapsa. Um modelo que atinge ~41% de acerto individual em k=8 consegue cumprir todas as oito restrições em apenas 5,7% das tentativas. O melhor modelo testado cai abaixo de 50% de sucesso no nível de probe com 7 restrições; 12 dos 15 modelos falham com 3 ou menos restrições simultâneas.
Contexto
LLMs são cada vez mais usados em ambientes que exigem adesão simultânea a múltiplas restrições explícitas — estrutura de raciocínio, limites de segurança, esquemas de saída. Restrições individuais são tratadas com competência, mas o regime composicional, em que muitas precisam valer juntas, era pouco caracterizado. O estudo preenche essa lacuna com um benchmark escalável e verificável.
Os autores também identificaram que as restrições não degradam igualmente. Restrições estruturais perdem 2x mais capacidade por restrição adicionada do que restrições lexicais. A diferença é explicada por um "gap de compreensão-manutenção": restrições que exigem rastreamento sustentado de informações sofrem mais do que decisões binárias imunes à composição.
Por que importa
O resultado tem implicações diretas para quem usa LLMs em produção. Sistemas que exigem múltiplas condições — como agentes que precisam seguir formato, tom, segurança e raciocínio ao mesmo tempo — operam em um regime de falha multiplicativa. Um modelo que parece competente em tarefas isoladas pode falhar de forma consistente quando recebe 5 ou 6 exigências simultâneas.
A descoberta de que as falhas são quase independentes é central: a acumulação é multiplicativa, não aditiva. Isso significa que o problema não é uma restrição específica, mas a combinação. A única correlação residual entre falhas vem de características compartilhadas de saída — por exemplo, uma contagem errada de frases invalida todas as restrições que dependem dela.
Impacto
No curto prazo, empresas que dependem de LLMs para tarefas com múltiplos requisitos precisam repensar o design de prompts e a divisão de tarefas. Em vez de exigir tudo de uma vez, pode ser mais eficiente decompor em etapas com menos restrições por chamada. O estudo também sugere que benchmarks tradicionais, que avaliam uma restrição por vez, superestimam a capacidade real dos modelos.
No médio prazo, a pesquisa abre caminho para técnicas de mitigação. Se a degradação é previsível e governada pela independência das falhas, é possível desenvolver métodos de verificação e correção que detectem restrições violadas antes da entrega final. A distinção entre restrições estruturais e lexicais também aponta para arquiteturas que priorizem o rastreamento sustentado.
O que muda
O estudo muda a forma como devemos avaliar LLMs: não basta medir desempenho em tarefas isoladas. A capacidade de seguir instruções precisa ser medida no regime composicional, com múltiplas restrições simultâneas. O CSE oferece uma ferramenta padronizada para isso, com verificação determinística e sem viés de juiz.
Para desenvolvedores, a lição é prática: confiar em LLMs para tarefas com mais de 5-6 exigências simultâneas é arriscado. O limite é consistente entre modelos — o melhor deles não passa de 7 restrições com 50% de sucesso, e a maioria não passa de 3.
O que vem agora
Os autores não anunciaram próximos passos no preprint, mas a natureza do estudo sugere duas direções: explorar técnicas de mitigação para reduzir o colapso composicional e expandir o benchmark para mais modelos e tipos de restrição. A comunidade de IA deve acompanhar a publicação final e possíveis versões revisadas.
Enquanto isso, empresas que usam LLMs em produção devem reavaliar seus fluxos de trabalho. A decomposição de tarefas e a verificação automática de restrições podem ser mais importantes do que escolher o modelo com maior pontuação em benchmarks tradicionais.