
NTEP-R ensina IA a gastar menos chamadas de ferramenta por resposta certa
Novo esquema de recompensa para modelos visão-linguagem reduz chamadas redundantes e garante evidência útil antes de responder
O que aconteceu
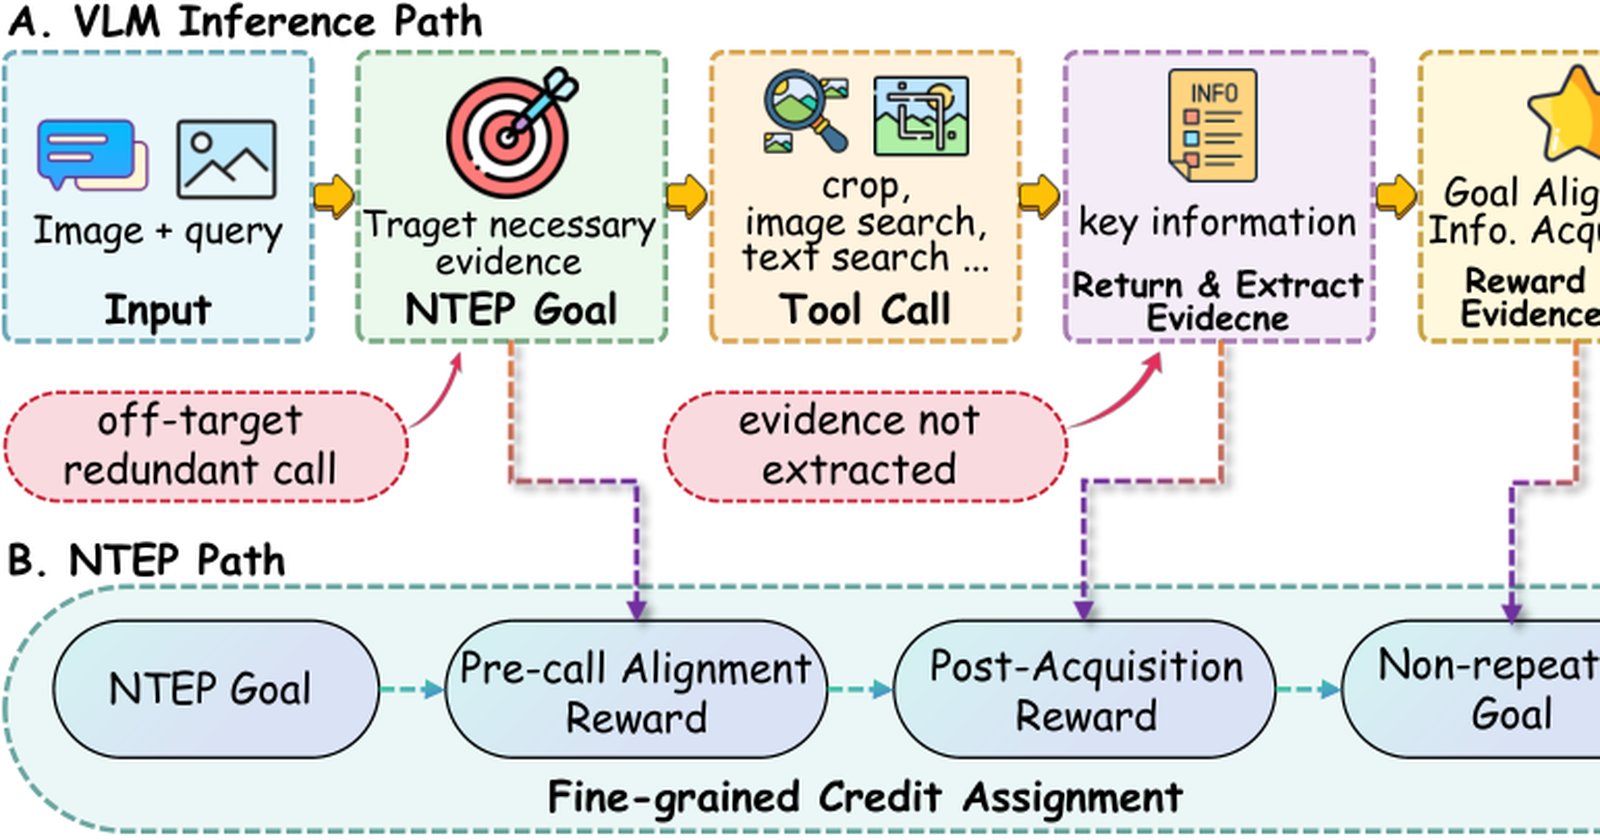
O artigo "Making Every Tool Call Count: Necessary Tool-Evidence Path Rewards for Agentic Vision-Language Models" foi submetido ao servidor arXiv em 3 de setembro de 2026, sob o identificador 2609.03493v1, na categoria Computer Science > Artificial Intelligence. Os autores propõem o NTEP (Necessary Tool-Evidence Path), um esquema de anotação que, para cada consulta, especifica de forma explícita qual evidência externa é essencial e qual chamada de ferramenta deve ser feita para obtê-la. Sobre essa base, eles definem o NTEP-R (NTEP Reward), mecanismo de supervisão que condiciona a recompensa ao avanço real do raciocínio a cada invocação de ferramenta. A instanciação do método, o modelo NTEP-8B, tem 8 bilhões de parâmetros e foi avaliada em sete benchmarks de tarefas com imagem. Segundo o resumo, o NTEP-8B melhorou de forma significativa tanto a precisão em tarefas orientadas a busca quanto a eficiência no uso de ferramentas, dentro de um framework unificado de três ferramentas.
O NTEP-R, mecanismo proposto no paper, atua em dois momentos. Antes da chamada, ele recompensa o modelo quando a intenção declarada se alinha a um objetivo de busca de evidência necessária. Depois, verifica se a informação resumida a partir da observação retornada pela ferramenta corresponde à evidência exigida para aquele passo. Os pesquisadores também introduziram um regularizador de objetivos não repetidos, que penaliza chamadas redundantes que revisitam objetivos já satisfeitos pelo NTEP.
Contexto
Modelos visão-linguagem modernos respondem bem a perguntas diretas sobre imagens, mas falham em consultas que exigem detalhes finos ou conhecimento externo que não está na própria imagem. Para preencher essa lacuna, VLMs agênticos passaram a invocar ferramentas como recorte de imagem (image cropping), busca de imagem e busca de texto. O problema, apontado no artigo, é que os paradigmas de treinamento atuais avaliam o uso de ferramentas apenas pela correção da resposta final. Essa supervisão fraca gera dois efeitos colaterais: modelos emitem chamadas redundantes ou fora do alvo, que não coletam a evidência necessária; e, mesmo quando chamam a ferramenta certa, frequentemente não extraem a informação relevante das observações retornadas. O NTEP ataca exatamente essa falta de supervisão intermediária.
Por que importa
O custo de uma chamada de ferramenta em produção não é trivial. Cada invocação de busca ou de processo de imagem consome tempo e recursos computacionais. Um sistema que gasta chamadas redundantes encarece a operação e atrasa a resposta ao usuário. O NTEP-R, ao punir chamadas repetidas e recompensar apenas passos que agregam evidência, ataca diretamente essa ineficiência. Para equipes que constroem agentes de IA com VLMs, o método oferece um caminho de treinamento mais disciplinado, em que o modelo aprende a buscar só o que falta. A melhoria relatada em sete benchmarks sugere que a abordagem não sacrifica precisão por economia, ela melhora as duas ao mesmo tempo.
Impacto
No curto prazo, o NTEP-R deve influenciar como outros grupos de pesquisa supervisionam agentes de visão e linguagem. A estrutura de recompensa baseada em evidência necessária pode ser adaptada a outros conjuntos de ferramentas além das três usadas no estudo. No médio prazo, aplicações como sistemas de suporte a diagnóstico por imagem, busca visual em e-commerce e assistentes que precisam consultar a web para responder sobre fotos podem se beneficiar de modelos que explicam e justificam cada passo intermediário. O regularizador de objetivos não repetidos, por sua vez, reduz o risco de loops em que o agente refaz a mesma busca sem avançar.
O que muda
A mudança central está na filosofia de treinamento. Em vez de julgar o agente só pelo resultado, o NTEP-R julga o processo e exige que cada chamada de ferramenta seja útil para o raciocínio. Isso muda o desenho das funções de recompensa em aprendizado por reforço para VLMs agênticos. O NTEP-8B, modelo de 8 bilhões de parâmetros criado na pesquisa, demonstra que essa supervisão granular é viável em escala prática. Para empresas que treinam modelos próprios, o esquema de anotação adiciona trabalho manual, pois exige rotular a evidência necessária e a chamada correspondente para cada consulta. O ganho em eficiência, porém, pode compensar esse custo inicial.
O que vem agora
O paper foi disponibilizado no arXiv em versão preliminar e ainda passará por revisão de pares. Os autores não divulgaram datas para liberação de código ou pesos do NTEP-8B, nem detalharam os resultados numéricos completos fora do resumo. A expectativa é que versões futuras do artigo apresentem as tabelas comparativas com os sete benchmarks. A comunidade de IA deve observar se o NTEP-R será validado por outros grupos em VLMs de tamanhos diferentes, como modelos de 70 bilhões de parâmetros, e se a técnica se estende a ferramentas de código e bancos de dados estruturados.