
Pesquisa com modelo de mundo latente melhora navegação de robôs
Abordagem prevê consequências de ações no espaço latente e melhora políticas sem interação extra com o ambiente
O que aconteceu
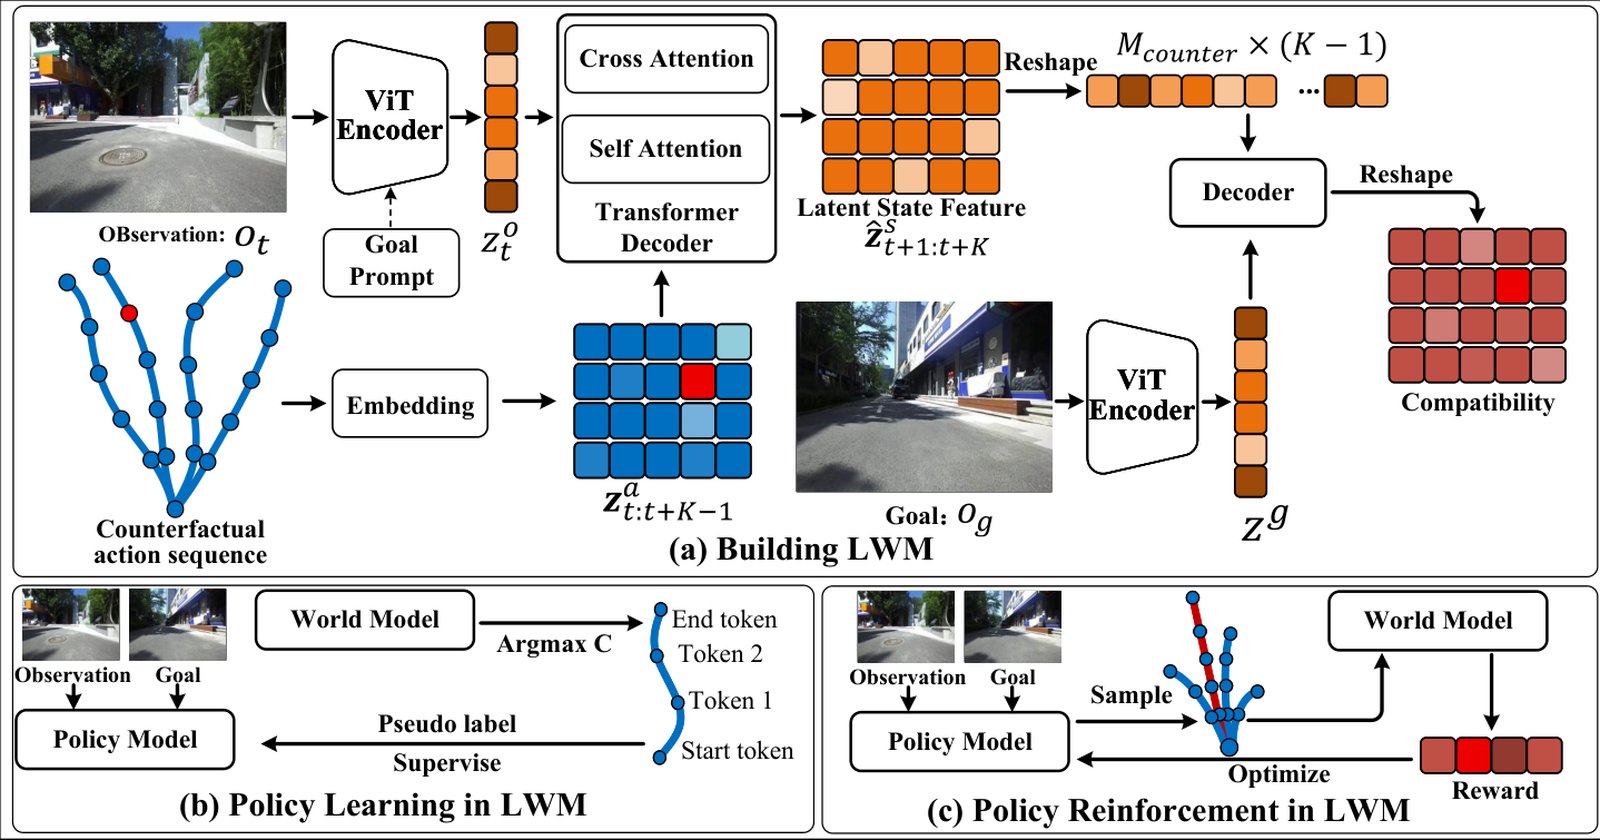
Um artigo submetido em 23 de agosto de 2026 ao repositório arXiv propõe o Latent World Model (LWM), um modelo de mundo latente para navegação de robôs. O estudo, catalogado como arXiv:2608.26190v1, está na categoria Computer Science > Artificial Intelligence. No artigo arXiv:2608.26190, os pesquisadores descrevem um modelo que prevê a compatibilidade entre ações e objetivos no espaço latente, em vez de reconstruir observações futuras.
O resumo do trabalho afirma que o LWM supera métodos anteriores de world model e de imitation learning em precisão de predição, aprendizado de políticas e desempenho em navegação no mundo real. Os testes foram feitos em múltiplos conjuntos de dados reais de navegação de robôs. O código, os modelos pré-treinados e materiais complementares estão disponíveis em https://wzm206.github.io/latent-world-model-nav
Contexto
World models são arquiteturas que permitem a um agente raciocinar sobre resultados futuros e aprender políticas com base no conhecimento da transição de estados. A abordagem dominante nos últimos anos reconstroi observações ou características futuras. Segundo o resumo, isso introduz complexidade desnecessária e limita a eficácia para a tomada de decisão.
O LWM parte de outra premissa: proximidade espacial se correlaciona com similaridade de features latentes. Com isso, as consequências de uma ação podem ser avaliadas diretamente no espaço latente, sem reconstruir o ambiente. Para o treinamento contrafactual, o modelo amostra sequências de ações ao longo das trajetórias e aprende a prever quais dessas sequências aproximam o agente do objetivo. Esse mecanismo permite responder perguntas do tipo "e se o robô fizer este movimento?" sem executar a ação no ambiente físico.
Por que importa
O custo de anotar ações para treinar robôs é um dos principais gargalos da robótica. O LWM elimina essa necessidade: ele aprende políticas a partir de vídeo não rotulado e melhora essas políticas com reinforcement learning inteiramente dentro do modelo de mundo. Isso significa que o treinamento pode ser feito com dados mais baratos e disponíveis, como gravações de robôs em operação, e com menos interação com o ambiente real.
Na prática, o método também reduz a complexidade computacional. Em vez de prever imagens ou mapas completos do futuro, o modelo trabalha com uma representação compacta. Para empresas que desenvolvem robôs de entrega, veículos autônomos leves ou sistemas de movimentação em armazéns, a abordagem pode encurtar o ciclo entre coleta de dados e política de navegação pronta para teste.
Impacto
O impacto imediato é no campo de aprendizado de robôs. O LWM se junta a uma linhagem de modelos de mundo dirigidos por imaginação, nos quais o agente treina em cenários simulados internamente e só depois transfere o comportamento para o hardware. A diferença é que, aqui, a simulação acontece em um espaço latente de features, e não em uma reconstrução visual do mundo.
Em um horizonte mais curto, a pesquisa deve circular entre grupos acadêmicos que trabalham com navegação autônoma. Como o código e os modelos pré-treinados foram liberados, outros laboratórios podem reproduzir os experimentos e testar o LWM em suas próprias bases. Isso tende a acelerar a validação independente dos resultados.
O que muda
A mudança central é arquitetural. Modelos de mundo anteriores costumam se concentrar em reconstruir o futuro, o que gera um custo de computação e um nível de detalhe que nem sempre é útil para decidir. O LWM troca a reconstrução por uma previsão de compatibilidade. O modelo aprende qual ação, ou qual sequência de ações, deixa o agente mais próximo do objetivo no espaço latente.
Outra mudança está no papel do reinforcement learning. No pipeline proposto, o modelo de mundo supervisiona o aprendizado inicial de política a partir de vídeos não rotulados e, depois, o refinamento via reinforcement learning acontece dentro do próprio modelo. Isso reduz a necessidade de interação com o ambiente físico durante o treinamento.
O que vem agora
Os pesquisadores disponibilizaram o projeto sob o endereço https://wzm206.github.io/latent-world-model-nav. Na página, estão o código e os modelos pré-treinados usados nos experimentos. A publicação ainda é um preprint, o que significa que não passou por revisão por pares em conferência ou periódico. O resumo não informa prazos para publicação em conferência ou para integração em produtos.
A expectativa natural é que o LWM seja testado em cenários mais desafiadores, como ambientes com obstáculos dinâmicos ou terrenos irregulares. Também cabe à comunidade avaliar o comportamento do modelo quando a quantidade de vídeos de treinamento cresce ou quando a tarefa muda de navegação ponto a ponto para exploração ou cobertura de área.
Fontes
- arXiv: Predicting Consequences and Reinforcing Navigation Policies with Latent World Models (arXiv:2608.26190v1): https://arxiv.org/abs/2608.26190
- Página do projeto: https://wzm206.github.io/latent-world-model-nav