
PLUME: método personaliza LLMs com 95% menos parâmetros por usuário
Framework apresentado no arXiv treina apenas uma pequena matriz por usuário dentro de um subespaço compartilhado, mantendo desempenho igual ou superior a baselines fortes
O que aconteceu
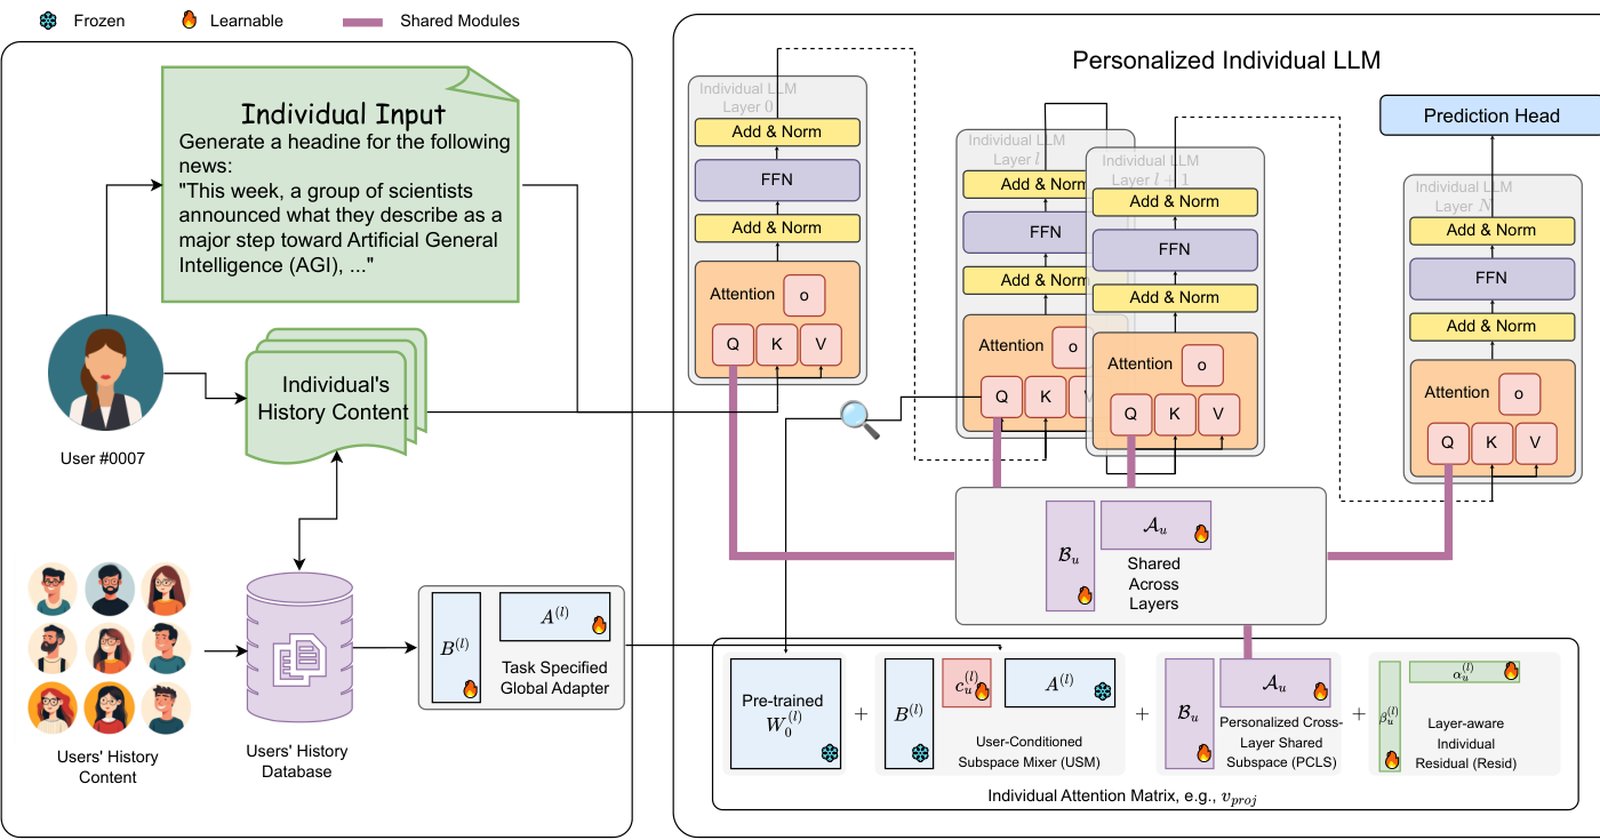
Um novo artigo no arXiv, registrado sob o identificador 2609.04715v1 e submetido em 4 de setembro de 2026, propõe o PLUME (Personalized Low-Rank Adaptation through User Modulation and Shared Subspace). O PLUME é um framework leve de personalização de LLMs que resolve um gargalo conhecido: o fine-tuning por usuário melhora a qualidade da personalização, mas gera custo alto de parâmetros e armazenamento, o que impede escalar para grandes populações de usuários.
A proposta funciona em duas etapas. Primeiro, o PLUME aprende um subespaço global da tarefa a partir de dados agregados de usuários. Depois, a personalização é feita treinando apenas uma pequena matriz quadrada dentro desse subespaço, enquanto os componentes compartilhados permanecem fixos. O framework do PLUME ainda introduz parâmetros compartilhados entre camadas (cross-layer) e termos residuais de rank-1 para reduzir redundância sem perder expressividade.
Nos experimentos, conduzidos em múltiplos benchmarks de geração de texto personalizada, o PLUME alcançou desempenho comparável ou superior ao de baselines fortes, com redução de mais de 95% nos parâmetros por usuário. Esses resultados constam do resumo oficial do artigo no arXiv.
Contexto
Personalizar LLMs é considerado pelos autores do PLUME algo essencial para entregar assistência de IA alinhada ao estilo, às intenções e às preferências de cada usuário. O caminho tradicional, o fine-tuning individual, entrega qualidade, mas cria sobrecarga significativa de parâmetros e armazenamento. Essa sobrecarga é justamente o que limita a escalabilidade quando o número de usuários cresce.
O PLUME ataca esse problema com a ideia de subespaço compartilhado: em vez de cada usuário carregar um conjunto completo de ajustes, todos aproveitam um subespaço aprendido coletivamente, e cada pessoa adiciona apenas uma modulação mínima. Os autores descrevem essa abordagem como "modulação de subespaço compartilhado com residuais mínimos", fundamentada semanticamente e escalável.
Por que importa
A redução de mais de 95% nos parâmetros por usuário muda a conta de quem opera assistentes de IA em escala. Um serviço com milhões de usuários não precisa mais armazenar um modelo ajustado completo para cada pessoa. O custo de armazenamento e a complexidade operacional caem, enquanto a personalização individual, que depende do histórico e do estilo de cada usuário, se mantém.
Para empresas que oferecem assistentes de IA, isso significa viabilidade econômica para personalização fina. Para usuários finais, o resultado prático é um assistente que entende melhor o estilo e as intenções individuais sem que o provedor precise multiplicar infraestrutura.
Impacto
No curto prazo, o PLUME entra como baseline a ser comparado em pesquisas de personalização de LLMs, já que os benchmarks usados no artigo mostram vantagem sobre métodos concorrentes. No médio prazo, a arquitetura de subespaço compartilhado com matriz quadrada pequena por usuário pode ser adotada por plataformas que precisam servir personalização a grandes populações, de assistentes de escrita a agentes de atendimento.
O artigo foi publicado no repositório arXiv, na categoria Computer Science > Artificial Intelligence, e está disponível em PDF e HTML experimental, com ferramentas associadas como Bibliographic Explorer, Connected Papers e alphaXiv para quem quiser aprofundar.
O que vem agora
O PLUME está em estágio de preprint no arXiv (submissão de 4 de setembro de 2026, versão v1). Os próximos passos naturais são a revisão pela comunidade, replicações independentes dos benchmarks de geração de texto personalizada e, possivelmente, disponibilização de código e dados associados, que o próprio arXiv lista como seções de acompanhamento do artigo. Não há, no material divulgado, anúncio de produto comercial ou data de implementação em produção.