
Pro-Router: método mais rápido para roteamento de IA multimodal
Sistema progressivo decide entre modelo pequeno e nuvem a cada token, elevando vazão em 75%.
O que aconteceu
O Pro-Router, um novo método de roteamento de modelos multimodais de linguagem, foi apresentado em um artigo científico enviado ao arXiv em 28 de agosto de 2026. O artigo arxiv, identificado como 2608.28726, detalha um sistema que combina decisão progressiva em dois estágios com colaboração adaptativa entre borda e nuvem. O objetivo é reduzir o custo computacional da inferência de MLLMs sem sacrificar precisão.
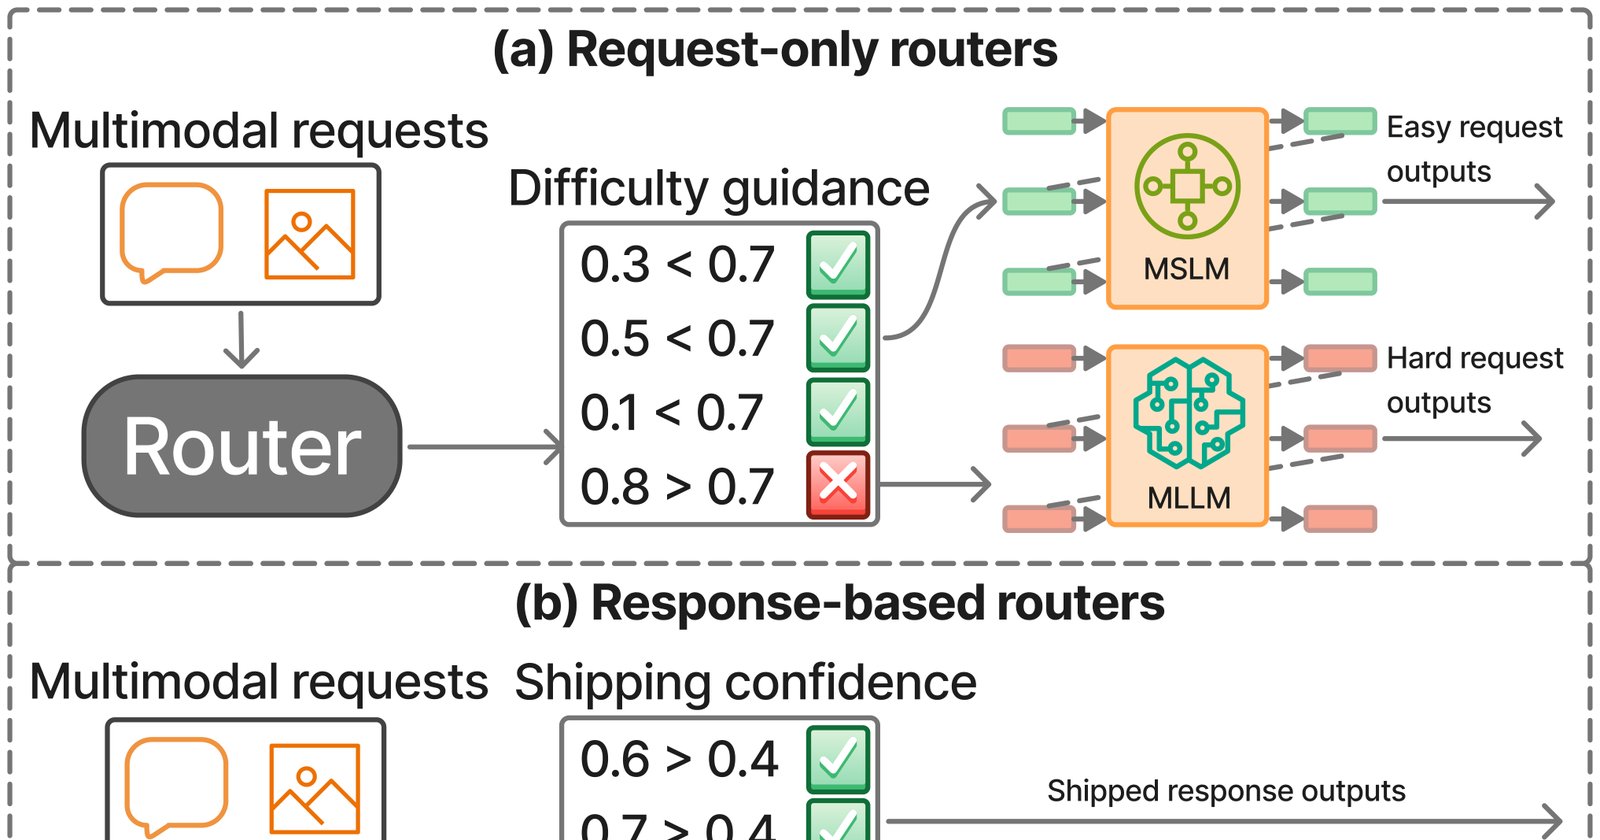
O método Pro-Router, segundo o resumo do trabalho, emprega primeiro um módulo leve chamado prompt pre-scorer para triagem rápida antes de qualquer geração de token. Esse pré-scorer guia solicitações aparentemente simples para modelos pequenos. Em seguida, um verificador token-aware lê a distribuição de probabilidade de amostragem de cada token que o modelo pequeno gera, estimando a confiança do modelo em sua própria resposta para decidir se o resultado pode ser enviado ou precisa escalar para um modelo de alta precisão baseado em nuvem.
Os experimentos, realizados em múltiplos benchmarks multimodais e com diversos modelos, mostram que o Pro-Router atinge a maior precisão de roteamento entre os métodos comparados e melhora a velocidade de roteamento em mais de 10 vezes em relação às alternativas. A mais alta precisão de roteamento, segundo o abstract, é alcançada pelo Pro-Router, que também apresenta vazão ponta a ponta mais de 75% superior ao pipeline de roteamento de modelo existente. O código do Pro-Router, disponível no GitHub em https://github.com/xinyuangui2/pro-router permite reprodução dos resultados.
Contexto
O custo computacional de modelos multimodais de linguagem é um dos principais entraves para sua adoção em tempo real. MLLMs processam texto, imagem, áudio e vídeo, o que exige muito poder de processamento. Abordagens tradicionais de roteamento de modelos ou decidem apenas com base em características grosseiras do nível da requisição, como tipo ou tamanho, ou usam uma ou mais passagens extras do modelo de linguagem para inspecionar a resposta gerada. Essas estratégias ignoram os sinais de incerteza no nível do token que emergem durante a geração, o que pode levar a escolhas subótimas entre um modelo leve e rápido e outro pesado e preciso.
O Pro-Router ataca essa lacuna ao usar justamente esses sinais de token para tomar a decisão de escalonamento. O pré-scorer da primeira etapa reduz o custo de triagem inicial, enquanto o verificador da segunda etapa observa a distribuição de probabilidade de cada token, algo que ocorre naturalmente durante a decodificação. Dessa forma, não há necessidade de passes extras caros: a decisão de escalar ou não é tomada a partir de dados que já estão sendo gerados pelo modelo.
Por que importa
A eficiência da inferência de MLLMs é decisiva para aplicações comerciais e de tempo real. Assistentes de voz que processam comandos combinados com câmera, sistemas de visão computacional em dispositivos de borda e atendimento automatizado com análise de sentimento são exemplos em que latência e custo por requisição pesam. O Pro-Router permite que empresas usem um modelo pequeno na ponta para a maioria das requests e apenas enviem os casos difíceis para a nuvem, reduzindo gastos com infraestrutura e melhorando a experiência do usuário.
No Brasil, onde o custo de acesso a GPUs e data centers é alto, otimizações como essa podem viabilizar a adoção de IA multimodal em fintechs, agronegócio e saúde, que dependem de resposta rápida e barata.
Impacto
No curto prazo, o Pro-Router pode ser integrado a pipelines de inferência existentes, substituindo roteadores baseados em regras fixas. O ganho de 75% na vazão ponta a ponta significa que um mesmo cluster de máquinas pode atender quase o dobro de requisições no mesmo tempo, ou que se pode usar menos servidores para a mesma carga. No médio prazo, a abordagem token-aware pode influenciar o design de frameworks de MLops, incentivando a coleta de métricas de confiança token a token para orquestração mais fina de modelos.
Outro impacto potencial está na redução da pegada de carbono de sistemas de IA. Ao despachar apenas casos complexos para a nuvem, o consumo de energia por requisição cai, algo relevante em um momento em que grandes provedores de nuvem são cobrados por sua eficiência energética.
O que vem agora
Os autores disponibilizaram o código no repositório GitHub xinyuangui2/pro-router, o que deve acelerar a reprodução e a adoção pela comunidade. Como se trata de um artigo submetido ao arXiv, ainda não passou por revisão por pares formal. Espera-se que os autores publiquem mais detalhes sobre os benchmarks exatos e as configurações de hardware utilizadas, além de possivelmente integrar o método a frameworks populares como Hugging Face e TGI. Pesquisadores independentes podem testar o Pro-Router em seus próprios modelos e conjuntos de dados, o que ajudará a validar os ganhos de velocidade e vazão em cenários além dos relatados no paper.