
Rankings de LLMs são definidos pela configuração do teste, mostra estudo
Pesquisa do arXiv mostra que 4 dos 12 modelos chegam ao 1º lugar conforme o harness
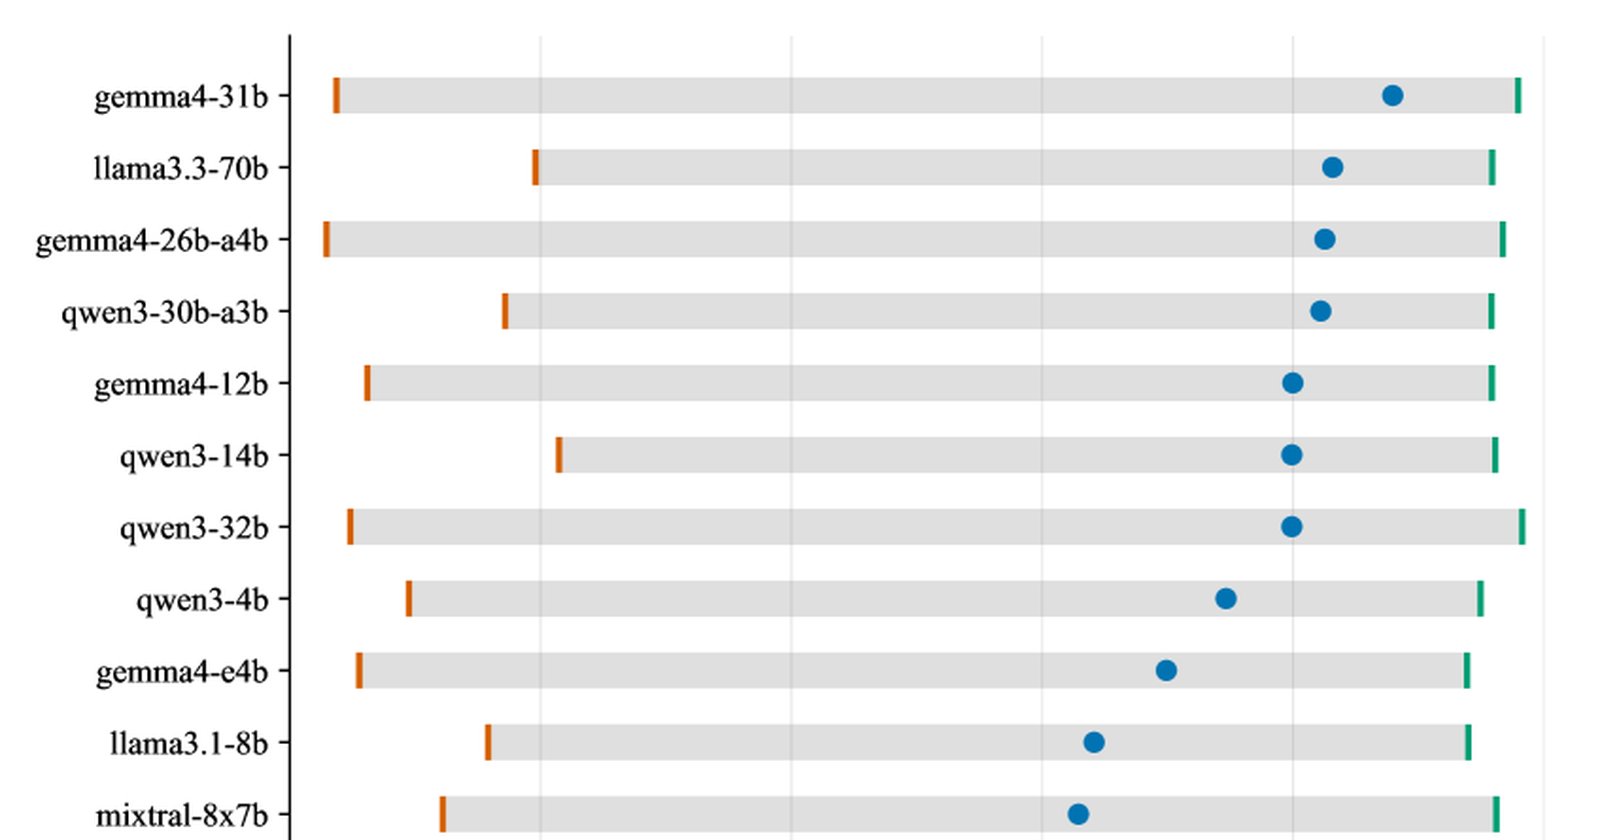
O que aconteceu
A pesquisa "There Is No Neutral Harness: Modern LLM Leaderboards Are Manufactured by Config-Fragile Items" foi submetida ao arXiv em 17 de julho de 2026, identificada como arXiv:2608.21382, na categoria Computer Science, subárea Artificial Intelligence. O autor, V Subrahmanya Raghu Ram Kishore Parupudi, tratou o harness de avaliação como variável independente e resolveu seu efeito até o nível de itens individuais.
A fragility grid, ferramenta central do trabalho, cruza 12 modelos de linguagem abertos (open-weight) com ajuste por instrução, vindos de 4 famílias, sobre 3.679 itens de 4 benchmarks: ARC, HellaSwag, MMLU e TruthfulQA. Foram testadas 26 configurações igualmente defensáveis, e cada combinação gera um bit de correção por modelo e item. Na grade, o modelo gemma4-31b registra nota entre 31% e 89% conforme apenas o harness muda. A comparação é pareada, com itens, pesos e greedy decoding fixos, então toda a variação vem da configuração. O intervalo de 31% a 89%, anotado no artigo, é ilustrativo do tamanho do efeito.
Contexto
Benchmarks de múltipla escolha fixam as perguntas e as respostas corretas. Não fixam o harness: a ordem das opções, a redação do prompt e se a resposta é lida do texto gerado ou das probabilidades de cada opção (per-option likelihoods). Trabalhos anteriores relataram essa sensibilidade como variação de nota agregada, sem examinar sobre quais itens a variação recai. O estudo resolve o efeito até itens individuais, um avanço sobre essa média.
Três resultados se destacam. Nos itens em que dois modelos adjacentes respondem de forma estável, o par fica empatado. Os itens frágeis a mudanças de configuração carregam, em média, 95,7% da diferença entre um par de modelos. A distância entre dois concorrentes consecutivos no ranking vem quase toda de itens cuja resposta muda com o harness.
Por que importa
Quatro dos 12 modelos alcançam o primeiro lugar sob alguma configuração do harness. O harness seleciona o vencedor. Um leaderboard que não controla essas escolhas pode coroar um modelo apenas porque a configuração o favoreceu. Para quem usa rankings para adotar um modelo, comparar fornecedores ou basear integrações, o resultado vira um dado arbitrário apresentado como fato.
O eixo que sustenta o resultado é a escolha de pontuação, não a ordem das opções, que os protocolos costumam fixar. Ler a resposta do texto gerado ou usar a probabilidade de cada opção muda o ranking mais do que embaralhar alternativas.
Impacto
A descoberta afeta também os métodos de compressão de benchmarks, usados para acelerar avaliações. A propriedade que esses métodos maximizam, chamada item discrimination, correlaciona com a fragilidade em 0,28 (intervalo de confiança de 95% entre 0,25 e 0,30). A compressão mantém os itens frágeis em vez de removê-los. Conjuntos menores tendem a preservar justamente os itens que não resistem a uma troca de harness, contaminando comparações rápidas entre modelos.
O que muda
Os autores liberam os registros por item e o script de análise. Cada número do artigo regenera em uma CPU em segundos, o que torna a verificação prática para qualquer equipe. A fragility grid se posiciona como um controle que um leaderboard pode rodar antes de reportar uma ordem de classificação.
O que vem agora
O passo natural é a adoção da grade como etapa pré-publicação em leaderboards públicos e internos das empresas. A exigência prática, sugerida pelo estudo, é que as plataformas declarem cada decisão de harness e publiquem a faixa de variação dos modelos, e não apenas a nota pontual. Sem essa transparência, o estudo indica que rankings continuarão fabricando vencedores por configuração. A comunidade de avaliação de LLMs passa a ter um instrumento para medir, item a item, onde está a fragilidade de cada benchmark.