
Trident: Arquitetura Ataca Gargalo de Reranking em VQA de Documentos Longos
Sistema proposto no arXiv combina anotação semântica e módulo de geração para selecionar evidências visuais e textuais complexas.
O que aconteceu
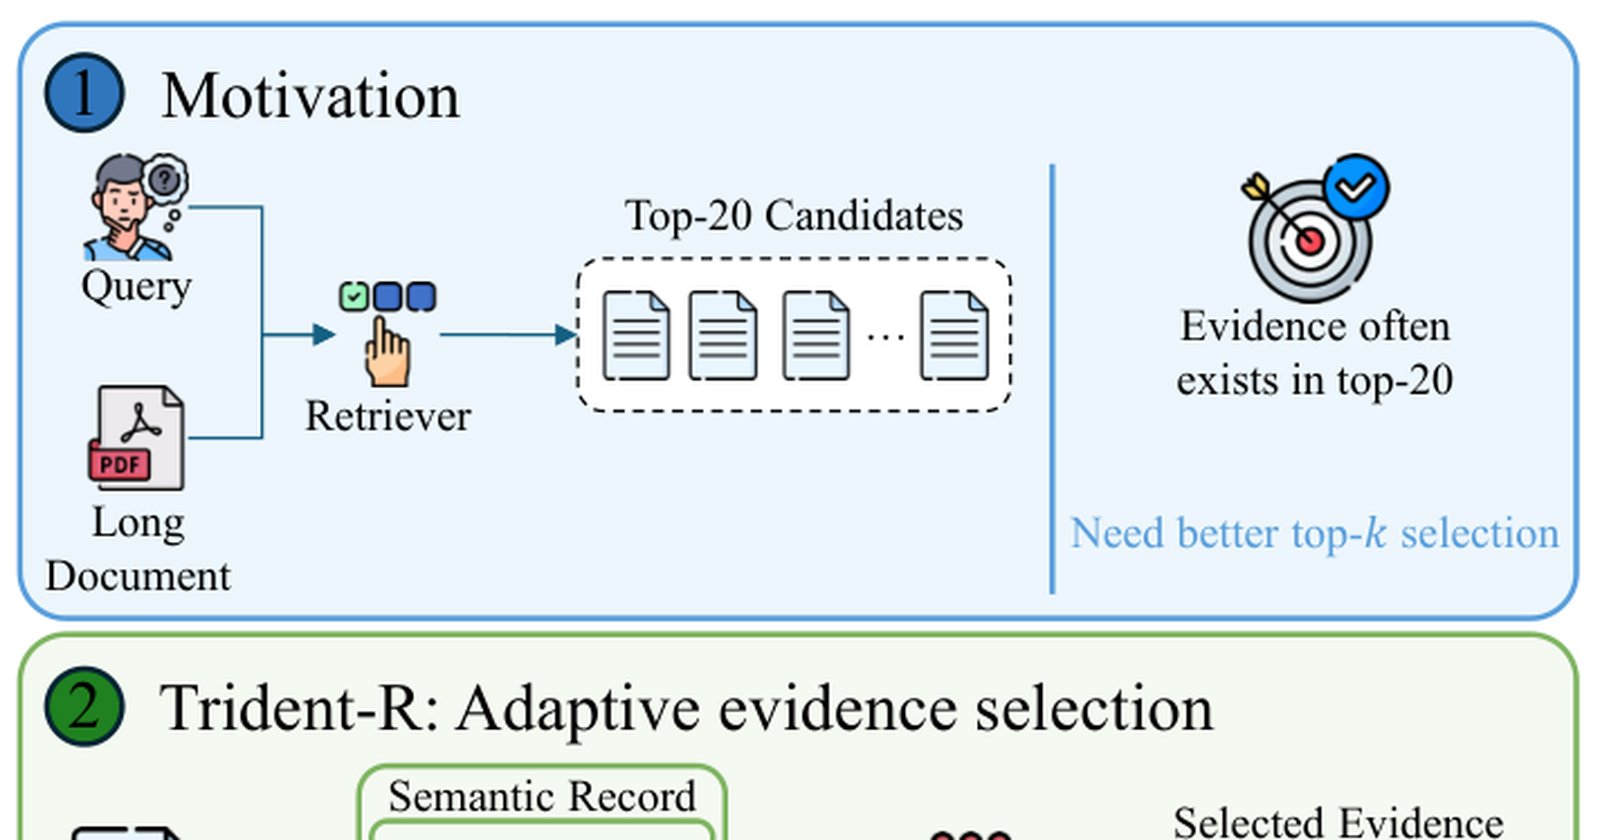
Pesquisadores publicaram o paper "What the Reranker Sees: Multi-Aspect Page Annotation for Long-Document Multimodal Question Answering" no arXiv (14/ago/2026). O estudo identifica que, em pipelines de VQA para documentos longos, o gargalo não está na recuperação inicial (recall), mas na seleção de evidências feita pelo reranker. No benchmark MMLongBench-Doc, o modelo BGE-M3 atinge um Recall@20 de 0.86, mas seu F1@5 cai para apenas 0.254. Mesmo o retriever visual ColPali, que processa imagens, alcança apenas F1@5 de 0.332. O problema central é que rerankers baseados em LLMs que veem apenas trechos de texto falham ao ignorar evidências em tabelas, gráficos e layout, mesmo quando o retriever upstream já codificou essas imagens.
Para resolver isso, foi proposto o Trident, com dois componentes: o Trident-R, um reranker agnóstico ao retriever que converte cada candidato em um registro semântico legível por LLM (incluindo legenda visual, caminho da seção, tags de entidade e trecho de texto) antes de um rerank com K adaptativo; e o Trident-S, um módulo de geração que instrui o VLM (Vision-Language Model) a analisar a informação sob lentes tópicas, de entidade e estruturais antes da síntese final.
Contexto
A abordagem padrão para VQA em documentos longos são os pipelines "retrieve-then-read". Com documentos que misturam texto, tabelas e figuras, a complexidade aumenta. O estudo aponta que, mesmo com retrievers avançados, a etapa de reranking é o ponto de falha. A pesquisa avaliou o Trident em dois conjuntos de dados longos e demonstrou que o protocolo de anotação + reranking melhora substancialmente o F1 de recuperação em cinco pools heterogêneos, superando a baseline mais forte, o PageIndex.
Por que importa
Isso tem implicações práticas para empresas e desenvolvedores que trabalham com análise automatizada de relatórios financeiros, documentos legais, artigos científicos ou manuais técnicos. A melhoria na seleção de evidências visuais e textuais complexas é crucial para a confiabilidade de sistemas de IA que precisam "entender" documentos compostos. A arquitetura Trident ataca diretamente a perda de informação que ocorria mesmo em sistemas com recuperação inicial forte.
Impacto
No curto prazo, o Trident demonstra que a anotação semântica estruturada é um componente chave, e não apenas o reranking com LLM em si. Sem essa anotação, o reranking quase não altera o ranking do primeiro hit. No médio prazo, o módulo Trident-S adiciona até 6.6 pontos de precisão em geração para perguntas de síntese abertas. A configuração melhor do Trident foi a pipeline downstream mais forte na avaliação, com rankings consistentes entre dois juízes LLM (kappa = 0.913). Isso sugere caminhos para sistemas de QA multimodal mais robustos.
O que vem agora
O paper abre espaço para a integração de módulos de anotação semântica avançados diretamente em pipelines de processamento de documentos. Os resultados incentivam o desenvolvimento de rerankers que não tratam visual e texto como modalidades isoladas, mas em um registro unificado. A abordagem pode ser expandida para outros domínios que lidam com informações complexas e multimodais em larga escala.