DAREBench: novo benchmark avalia 35 modelos de IA como agentes em 233 tarefas
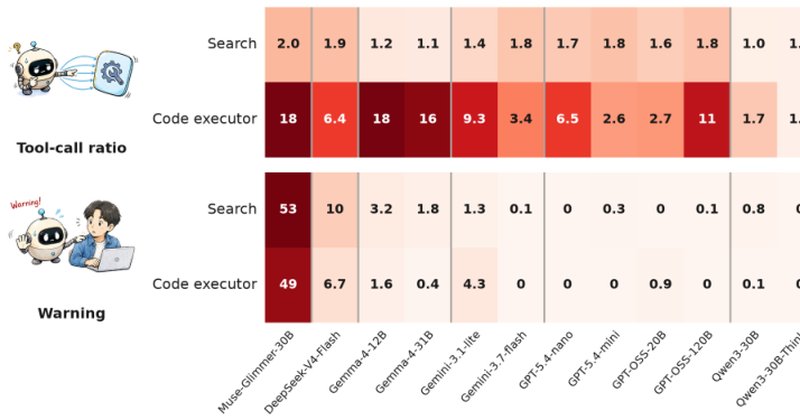
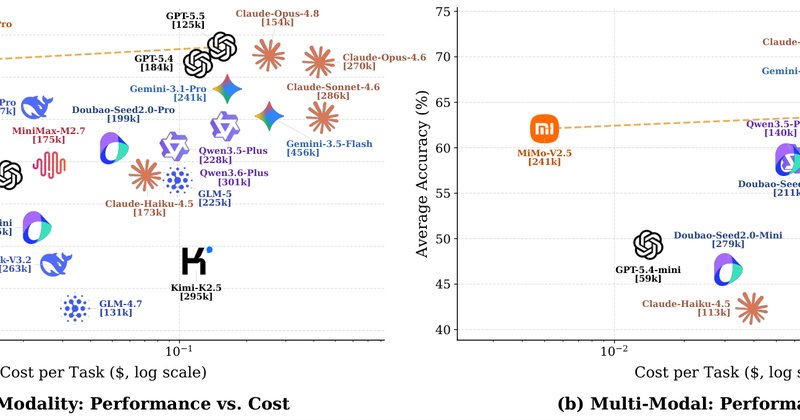
O DAREBench, novo benchmark publicado no arXiv, avaliou 35 modelos de IA como agentes em 233 tarefas e 7.587 rodadas de execução. Conclusão: nenhum modelo domina todos os grupos de tarefa, e a escolha deve considerar custo, modo de implantação e perfil de carga.