
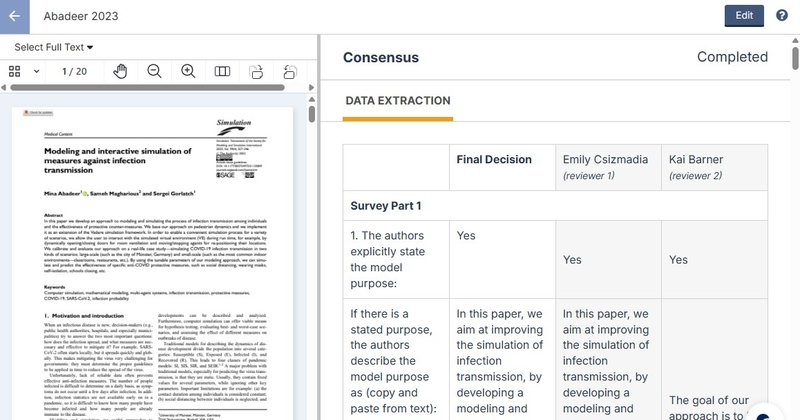
LLMs acertam até 81,67% em revisão de literatura sobre doenças
Estudo do arXiv mostra que GPT-4.1 e GPT-5.0 automatizam parte da revisão de literatura científica, mas com precisão abaixo da humana em campos subjetivos.
Estudo do arXiv mostra que GPT-4.1 e GPT-5.0 automatizam parte da revisão de literatura científica, mas com precisão abaixo da humana em campos subjetivos.
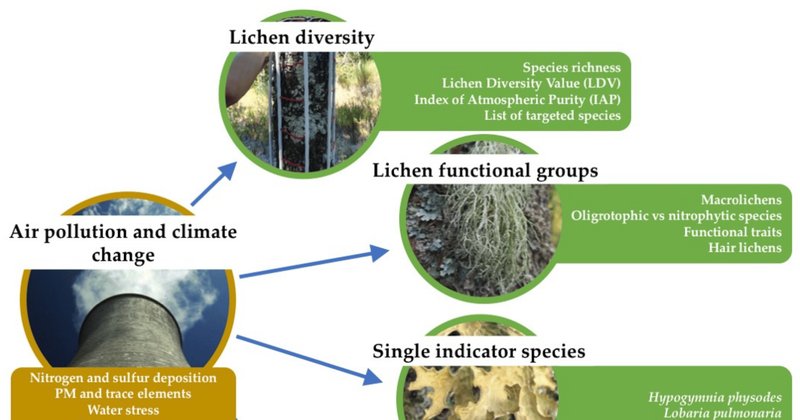
Paper do arXiv propõe o Relational Hypergraph Transformer (RHT), arquitetura que representa bancos relacionais como hipergrafos e reduz a complexidade da atenção em aprendizado multi-tabela. Testado no Synthea, o modelo alcançou embeddings mais coerentes que baselines, enquanto o XGBoost manteve vantagem em recall de códigos raros.
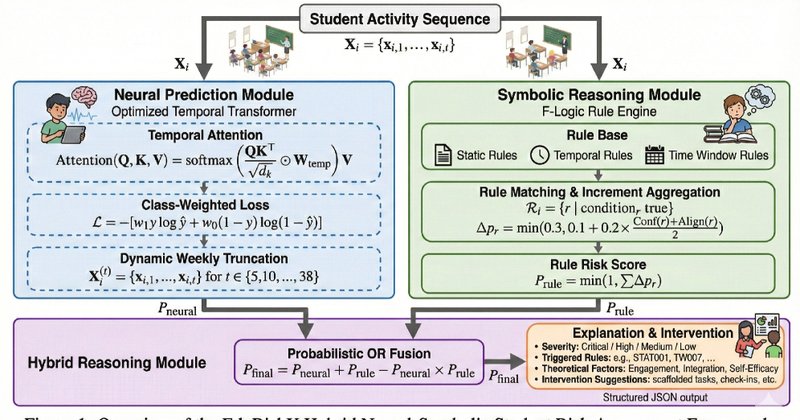
O EduRiskX, framework neuro-simbólico para previsão de risco acadêmico, alcançou acurácia de 0.900 e detecta evasão em média 9,32 semanas antes, com explicações por regras, em testes no dataset OULAD.
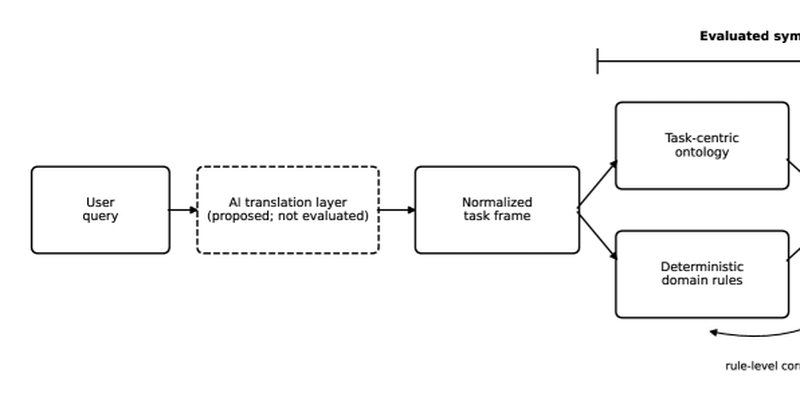
Pesquisador submeteu ao arXiv o ChemOntoRule, sistema que combina ontologia e regras determinísticas para acertar 296 de 300 questões de química do ensino médio, com ressalvas sobre generalização.
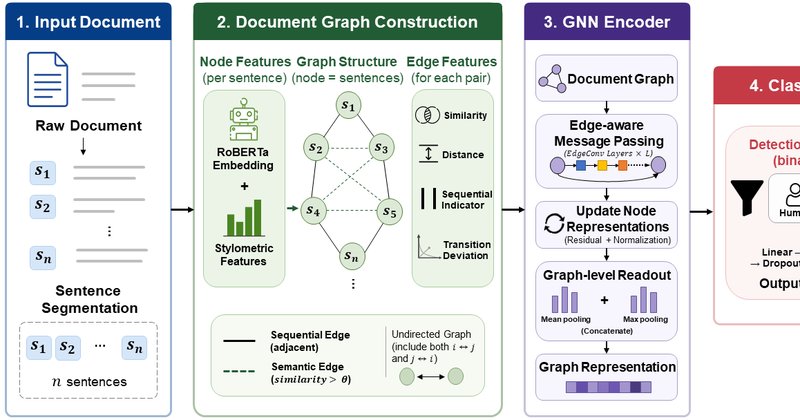
Estudo submetido ao arXiv em agosto de 2026 propõe o framework CSFG, que detecta texto gerado por IA com 97,14% de precisão e taxa de falso positivo de 1,57%, analisando variações de transição entre frases.
Pesquisadores apresentaram no arXiv o SIGMA, framework hierárquico que organiza agentes em grupos e integra as representações com atenção para manter coordenação sob ruído. Os experimentos no StarCraft II mostram ganhos de robustez em comparação a métodos existentes.
Pesquisadores apresentam o FrameFT, método de fine-tuning para Transformers que usa coeficientes esparsos em uma base de Fusion Frames, reduzindo memória e superando LoRA em benchmarks de linguagem e visão.
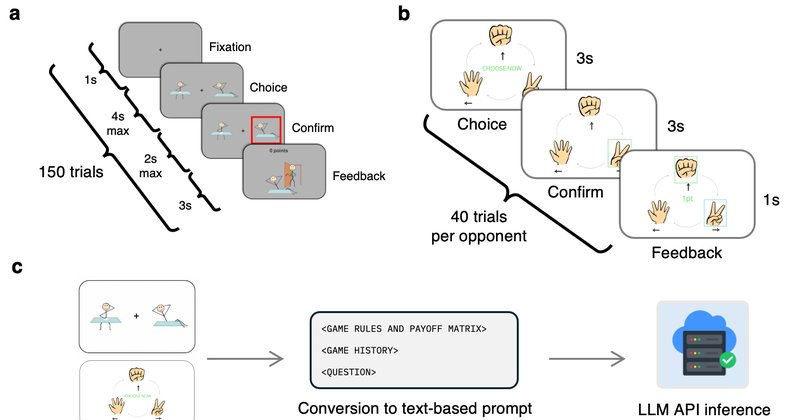
Estudo do arXiv testou 2.099 agentes de quatro famílias de LLMs em jogos econômicos e achou sinais de mentalização, com GPT-5 superando humanos em desempenho.
Estudo do arXiv submetido em agosto de 2026 propõe o Token Economy Score (TES) e mostra, com 151 avaliações, que raciocínio em LLMs compensa apenas em tarefas de cadeia sequencial, como AIME 2025 e LiveCodeBench.
Estudo publicado no arXiv em 26 de agosto de 2026 mostra que retry, timeout e circuit breaking falham em plataformas de agentes de IA, com 147 incidentes em 81 execuções e 12 bloqueios de trabalho correto. O paper propõe sete primitivas de confiabilidade centradas na delegação, não na mensagem.