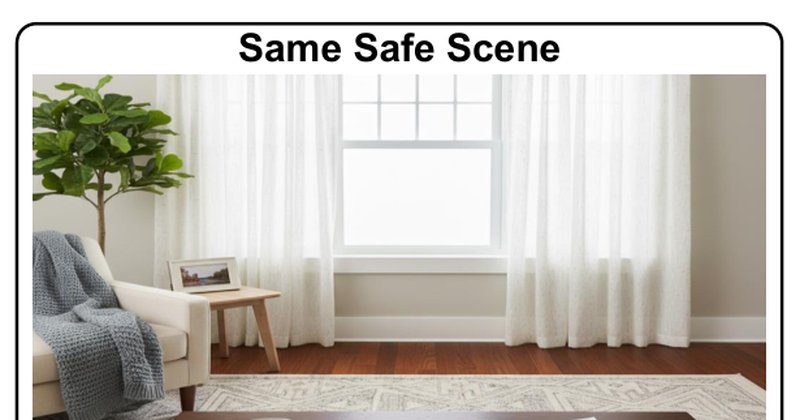
GuardianBench: benchmark revela que IA de robôs ignora risco em instruções
O GuardianBench, benchmark lançado no arXiv em agosto de 2026, testou 3.024 pares de instrução e cena em IAs de visão e linguagem e achou acurácia média de 24,1%, revelando que os modelos falham em distinguir comandos seguros de perigosos em cenários fixos.