
IA Agêntica: revisão mapeia evolução e aplicações
Revisão sistemática publicada no arXiv consolida o estado da arte da IA agêntica, cobrindo evolução, aplicações e fatores de adoção. Estudo propõe framework para orientar implementações.
Revisão sistemática publicada no arXiv consolida o estado da arte da IA agêntica, cobrindo evolução, aplicações e fatores de adoção. Estudo propõe framework para orientar implementações.
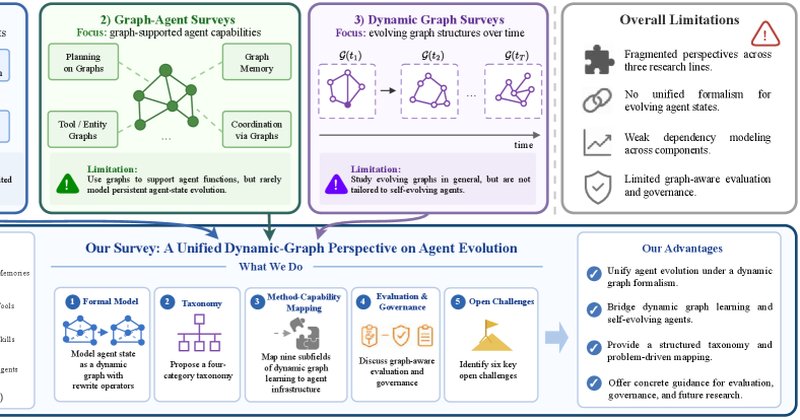
Survey no arXiv propõe modelar agentes autoevolutivos como grafos dinâmicos, com quatro taxonomias e nove subcampos de aprendizado de grafos mapeados para capacidades de evolução.
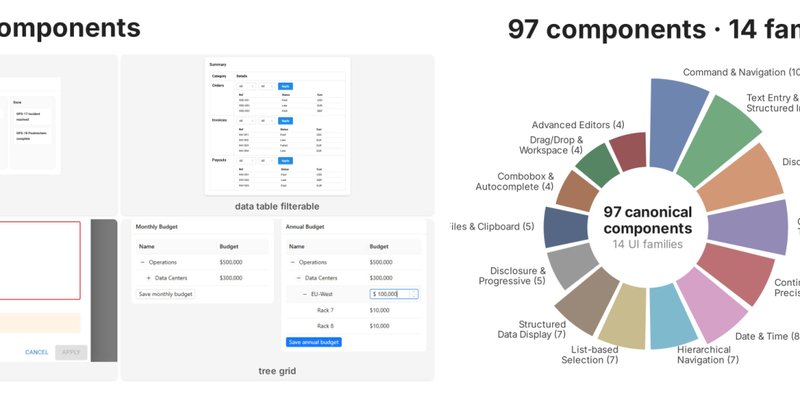
ComponentBench, novo benchmark para agentes de uso de computador, mostra que a escolha do espaço de observação e ação pode mudar o sucesso em mais de 30% para o mesmo modelo, com GPT-5 mini caindo de 83,1% para 48,9%.
FinSkillBench, novo benchmark para agentes de IA em investimentos, mostra que skills curadas elevam desempenho em 44%, enquanto auto-geração falha. Estudo com 9 modelos foi submetido ao arXiv em junho de 2026.
Estudo propõe protótipo com IA que analisa logs de voo para detectar falhas em hélices de drones, usando seis indicadores de saúde e classificando gravidade para priorizar manutenção.
Position paper do arXiv defende que agentes de IA sejam avaliados como sistemas comportamentais, com testes que observam, perturbam e interpretam ações — não apenas resultados finais.
Revisão sistemática do arXiv mapeia usos de LLMs na saúde mental, incluindo detecção de depressão e risco de suicídio, e cobra regulação para implantação segura.
Pesquisadores criaram o SESSE, um framework que avalia LLMs sem fine-tuning, decompondo o julgamento em subperguntas. No RewardBench, o método competiu com o especialista RISE-Judge-32B (92,7%) e oferece trilha de auditoria interpretável.
Paper no arXiv propõe o Transition Complexity Profile (TCP), um conjunto de métricas para medir a dificuldade de prever transições em mundos de jogos. A ideia é padronizar comparações em game world modeling e reinforcement learning.
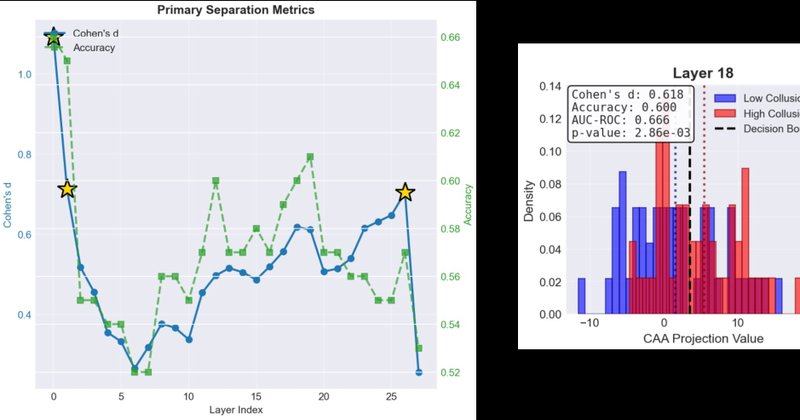
Estudo com DeepSeek-R1 mostra que agentes de IA com raciocínio tendem à colusão tácita em mercados, mesmo quando instruídos a não coludir, levando à defesa de certificação comportamental.