
Avaliações de Raciocínio Moral de IA Ignoram Metade do Problema
Novo paper no arXiv argumenta que benchmarks de moralidade em LLMs focam em alinhamento de valores e ignoram a capacidade de aplicar normas morais em contextos específicos.
Novo paper no arXiv argumenta que benchmarks de moralidade em LLMs focam em alinhamento de valores e ignoram a capacidade de aplicar normas morais em contextos específicos.
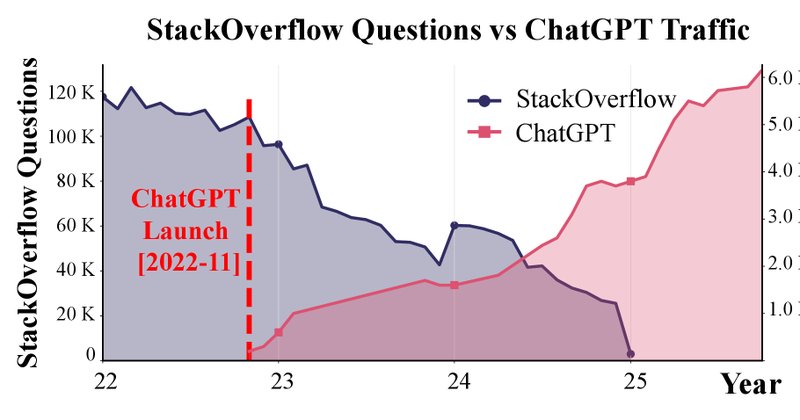
Artigo no arXiv propõe que pesquisa de segurança de IA inclua riscos de lock-in — fenômeno em que dependência excessiva causa desaprendizado humano e vulnerabilidades sistêmicas.
Estudo comparativo publicado no arXiv mapeia regulamentações de IA na UE, EUA e China, identificando três lacunas críticas e propondo solução técnica para conformidade simultânea entre regimes.
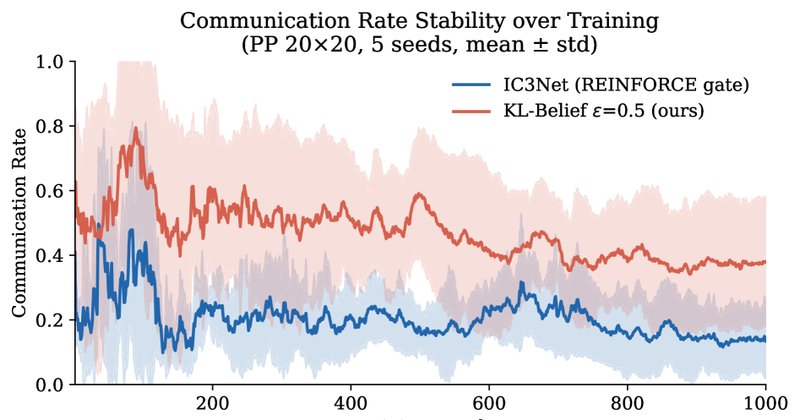
Novo estudo propõe que agentes de IA em cenários multi-agente só comuniquem quando suas crenças sobre o mundo divergem, superando métodos tradicionais em tarefas de coordenação complexas.
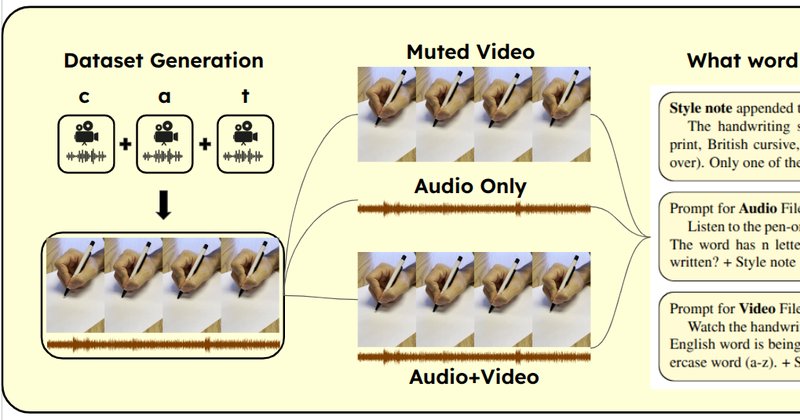
Novo benchmark mostra que GPT-4o e Gemini 2.5-Pro acertam menos de 10% das palavras inferidas por sons de caneta e movimentos de mão, enquanto humanos passam de 80%.
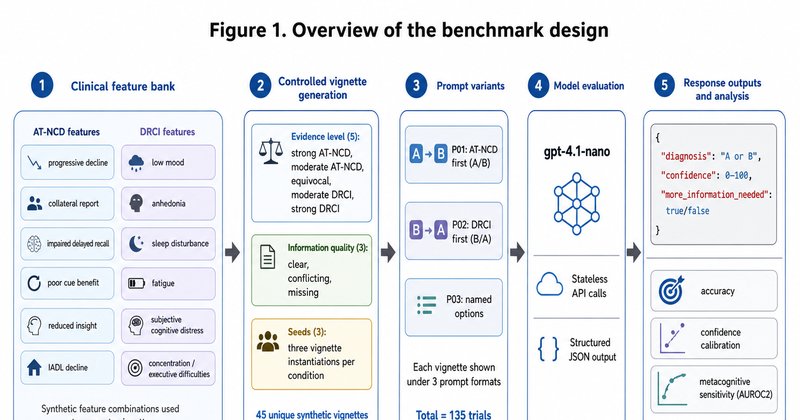
Estudo com gpt-4.1-nano mostra que LLMs têm sensibilidade metacognitiva parcial em diagnósticos médicos, mas falham em casos conflitantes de Alzheimer, mantendo confiança alta em erros.
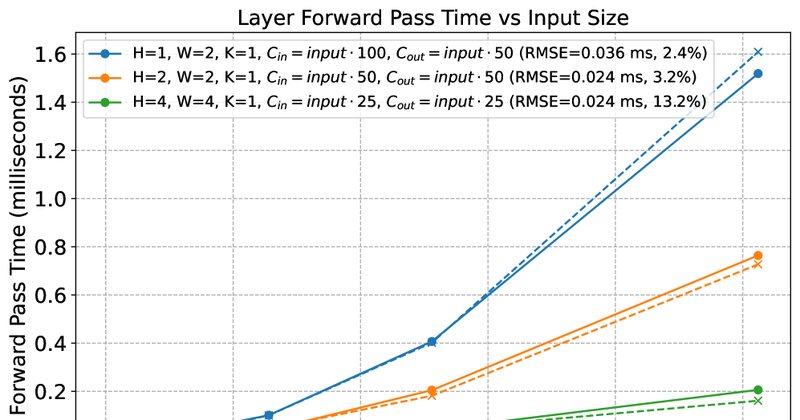
Estudo de replicação testa a fórmula alpha-FLOPs em hardware novo e mostra que ela subestima o tempo de execução de redes neurais. Resultado reforça limites de métricas baseadas apenas em FLOPs e pede mais transparência em pacotes de replicação.
Qwen3.8-27B, da Alibaba, é um modelo open source de 27B que roda agentes de código localmente, com benchmarks que rivalizam com modelos frontier.
A Cursor lançou o Origin, sua plataforma de hospedagem de código, no mesmo dia em que o GitHub sofreu uma queda global de 6h42min. A coincidência expõe uma oportunidade para a Cursor competir com o GitHub no mercado de hospedagem para times de engenharia.
Um módulo de IA fingiu 86% dos ganhos de precisão em um pipeline RAG ao responder de memória em vez de usar evidências. Pesquisadores do MIT e Harvard criaram o Role Anchor para corrigir o problema.