
Topologia de rede define cooperação entre agentes de IA, mostra estudo
Pesquisa com dilema do prisioneiro iterado mostra que vizinhos e identidade do oponente alteram resultados
O que aconteceu
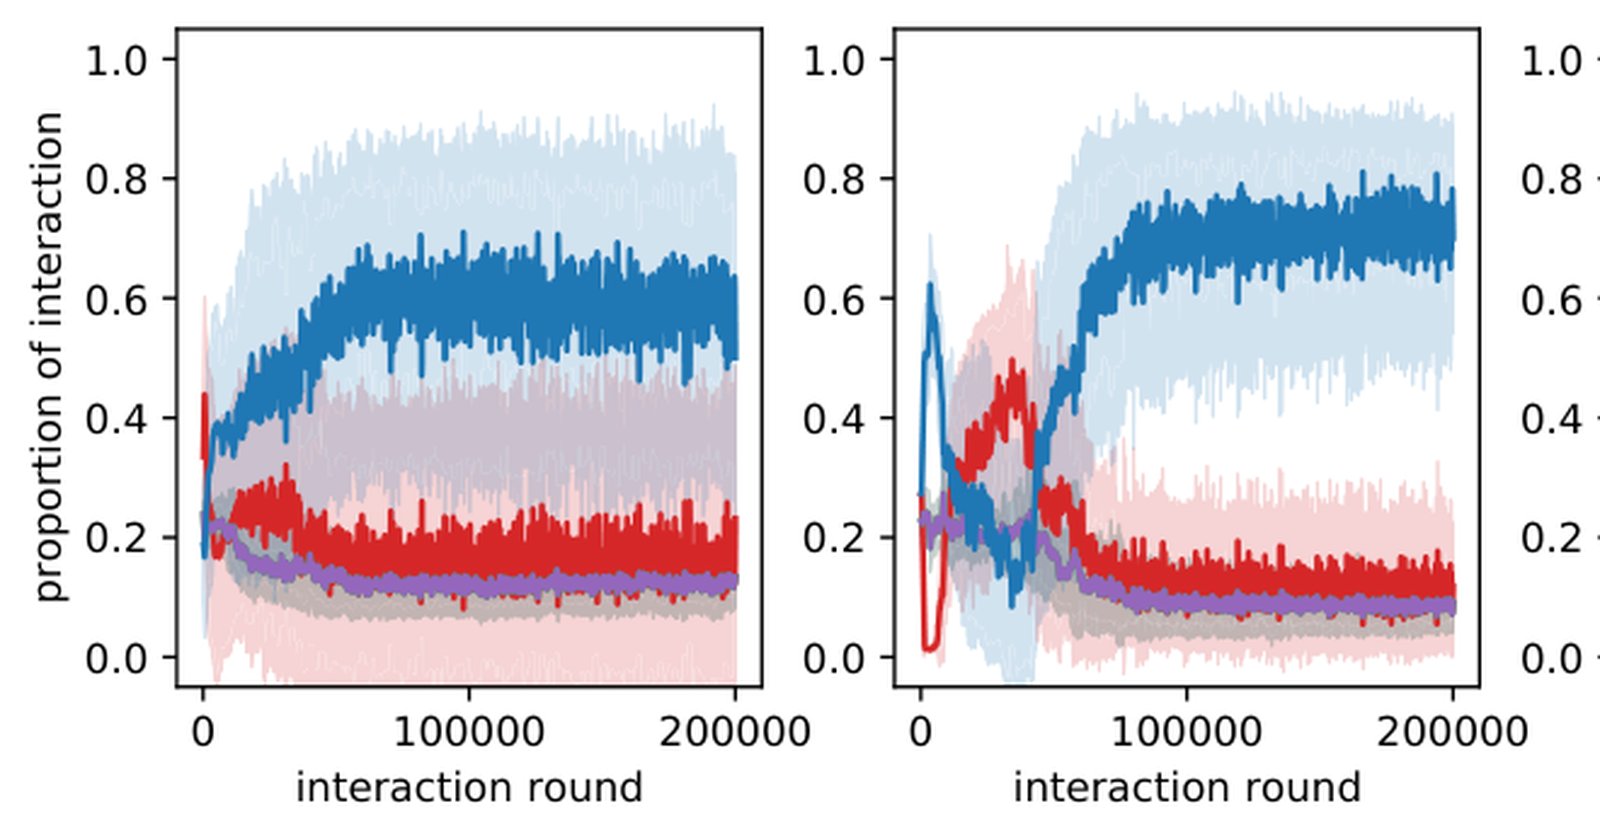
Pesquisadores submeteram ao arXiv, em 29 de agosto de 2026, o artigo intitulado "The Role of Network Topology and Opponent Information in Shaping Cooperation in Multi-Agent Reinforcement Learning Systems" (identificador arXiv:2608.28977). O trabalho analisa como agentes artificiais aprendem a cooperar quando organizados em grafos, no contexto do Dilema do Prisioneiro Iterado (IPD, na sigla em inglês). Cada agente é um nó do grafo, e seus vizinhos formam o conjunto de oponentes possíveis. Os autores testaram diferentes topologias de grafo e variações na informação fornecida aos agentes sobre seus adversários: histórico de ações e identidade do oponente.
Os resultados indicam que dois atributos estruturais do grafo, o número de vizinhos por nó e o caminho médio entre nós, são os principais responsáveis pela emergência de cooperação. Além disso, a pesquisa mostra que permitir que os agentes escolham seus parceiros favorece a cooperação mútua, porque reduz a diversidade do pool de oponentes. Por outro lado, quando os agentes recebem a identidade do oponente, a proliferação de estratégias cooperativas é dificultada. O estudo foi classificado na área de Computer Science > Artificial Intelligence e está disponível na plataforma arXiv.
O artigo, submetido na pré-impressão arXiv, ainda não passou por revisão por pares formal, mas representa uma contribuição relevante para a área de aprendizado por reforço multiagente. A pesquisa se diferencia da maior parte da literatura, que tradicionalmente modela a adaptação dos agentes por imitação de estratégias com base apenas nos payoffs acumulados de outros agentes. Aqui, cada agente aprende a jogar o IPD usando deep reinforcement learning, o que aproxima o modelo de sistemas mais complexos e realistas.
Contexto
O Dilema do Prisioneiro Iterado é um clássico da teoria dos jogos, usado há décadas para estudar cooperação. Em IA multiagente, o IPD serve como bancada de testes para entender quando agentes racionais desenvolvem estratégias como tit-for-tat ou outras formas de reciprocidade. A maior parte dos estudos anteriores focava em agentes que imitam estratégias bem-sucedidas observando payoffs, sem considerar a estrutura da rede de interações. Este novo trabalho amplia o escopo ao tratar cada agente como um nó em um grafo e permitir que as conexões definam com quem cada agente pode interagir.
A topologia de redes já é conhecida por influenciar comportamentos coletivos em sistemas biológicos e sociais. Em IA, porém, a combinação com aprendizado por reforço profundo, onde os agentes aprendem políticas por tentativa e erro, ainda é pouco explorada. O estudo preenche essa lacuna ao variar sistematicamente a estrutura do grafo e o tipo de informação disponível sobre o oponente.
Por que importa
A descoberta tem implicações práticas para o projeto de sistemas multiagente em áreas como robótica colaborativa, veículos autônomos e otimização distribuída. Se o número de vizinhos por nó e o caminho médio são fatores críticos, engenheiros podem ajustar a topologia da rede de comunicação entre agentes para promover cooperação ou evitar colusão, dependendo do objetivo. Por exemplo, em um sistema de entregas com drones, conectar cada drone a poucos vizinhos pode aumentar a confiança mútua, enquanto uma rede densa pode gerar comportamentos mais competitivos.
A constatação de que revelar a identidade do oponente atrapalha a cooperação também é relevante. Em sistemas onde os agentes precisam colaborar, fornecer identidades explícitas pode levar à formação de cliques ou discriminação contra certos agentes, reduzindo a eficiência global. Em mercados simulados por IA, isso pode afetar a formação de cartéis ou a competitividade.
Impacto
No curto prazo, o artigo influencia a agenda de pesquisa em aprendizado por reforço multiagente. Outros grupos podem reproduzir os experimentos usando o código disponível na plataforma do arXiv (o paper inclui links para ferramentas como alphaXiv e CatalyzeX). No médio prazo, os resultados podem orientar o design de sistemas de IA que operam em redes, como redes neurais distribuídas ou enxames de robôs.
O impacto mais imediato é metodológico. Ao mostrar que a topologia importa mais do que a imitação de payoffs, o estudo sugere que modelos futuros devem incorporar a estrutura da rede como variável explícita. Isso pode mudar a forma como os pesquisadores avaliam a cooperação em ambientes simulados, indo além das métricas tradicionais de payoffs.
Além disso, a descoberta sobre informação de identidade tem paralelos com debates sobre privacidade e anonimato em sistemas de IA. Em mercados online, por exemplo, saber com quem se negocia pode alterar o comportamento estratégico. As conclusões do artigo indicam que anonimato relativo pode favorecer cooperação em alguns contextos.
O que vem agora
Os autores não anunciaram uma versão revisada do paper ou a submissão a uma conferência específica. A comunidade de IA costuma discutir pré-impressões em workshops de aprendizado por reforço, como os de conferências como NeurIPS ou ICML. É provável que o trabalho seja apresentado em algum desses eventos em 2026 ou 2027.
Também é esperado que estudos de seguimento explorem outras variantes do IPD, como jogos com mais de dois jogadores, ou que testem diferentes algoritmos de deep reinforcement learning. A replicação dos experimentos com outras arquiteturas de redes, como redes sem escala ou aleatórias, pode refinar as conclusões sobre o papel do caminho médio.
Enquanto isso, o artigo já está acessível para a comunidade científica em https://arxiv.org/abs/2608.28977 permitindo que qualquer pesquisador examine os detalhes metodológicos e replique os resultados.