Agentes de IA falham ao simular valores humanos, aponta estudo

Agentes de IA falham ao simular valores humanos, aponta estudo

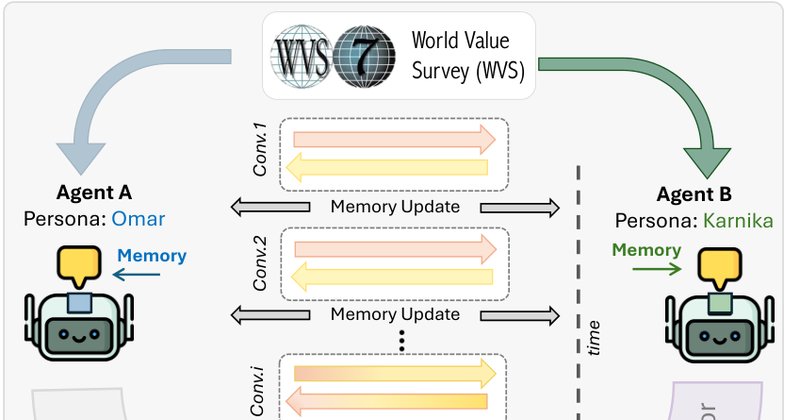
Estudo no arXiv simulou 4.000 conversas com 1.200 personas e três modelos (GPT-4o, Gemini-2.5-Flash e Gemma-4-E4B) ancoradas no World Values Survey. Mais de 50% das personas já falham em expressar o perfil de valores atribuído na primeira conversa, e apenas 2% a 7% derivam depois.
Por Redação Mapa Paper10 set
Compressão seletiva corta energia de LLMs de raciocínio

Compressão seletiva corta energia de LLMs de raciocínio

O preprint arXiv:2609.05512v1 propõe uma compressão que mede a vulnerabilidade de cada camada do modelo e restaura só os circuitos críticos para FP16. No ProofWriter, o R1-Qwen-7B ganha 12 pontos percentuais com 9,7% menos energia, enquanto o INT4 uniforme pode até aumentar o gasto total.

Por Redação Mapa Paper10 set
SCAFFOLD: agentes web que se aprimoram ganham 17,2 pontos

SCAFFOLD: agentes web que se aprimoram ganham 17,2 pontos

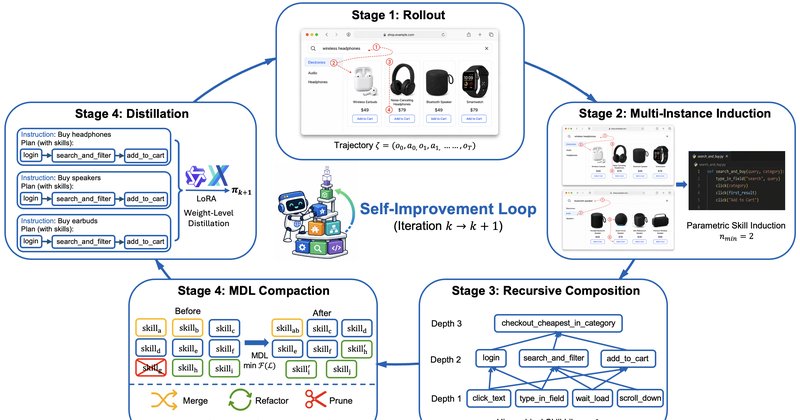
O SCAFFOLD, framework de agentes web visuais que se aprimoram sozinhos, supera o melhor baseline com habilidades em 11,1 a 17,2 pontos absolutos em WebArena, VisualWebArena e Online-Mind2Web. O código está aberto no GitHub.

Por Redação Mapa Paper10 set
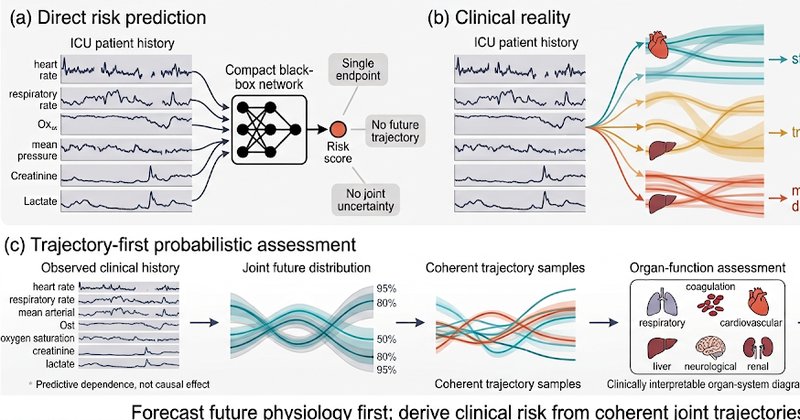
PGP-Clinical-TimeKAN: IA prevê trajetórias clínicas

PGP-Clinical-TimeKAN: IA prevê trajetórias clínicas

O PGP-Clinical-TimeKAN, framework de previsão de trajetórias clínicas publicado no arXiv, obteve o menor RMSE (0,52656) entre 13 modelos em uma coorte de 6.882 pacientes. O próprio artigo admite que a precisão em fisiologia não garante um detector de eventos confiável, com AUROC de 0,603 contra 0,650 do GRU-D.

Por Redação Mapa Paper10 set
RAPID: método de destilação corta custo quadrático em IA

RAPID: método de destilação corta custo quadrático em IA

O RAPID, método de destilação relacional submetido ao arXiv em 23 de agosto de 2026, separa a confiabilidade do alvo da prioridade de avaliação dos pares de exemplos. Nos testes com AG News e SST-2, o alvo com gate de confiabilidade atingiu as maiores acurácias médias observadas, 94,285% e 88,800%.

Por Redação Mapa Paper10 set
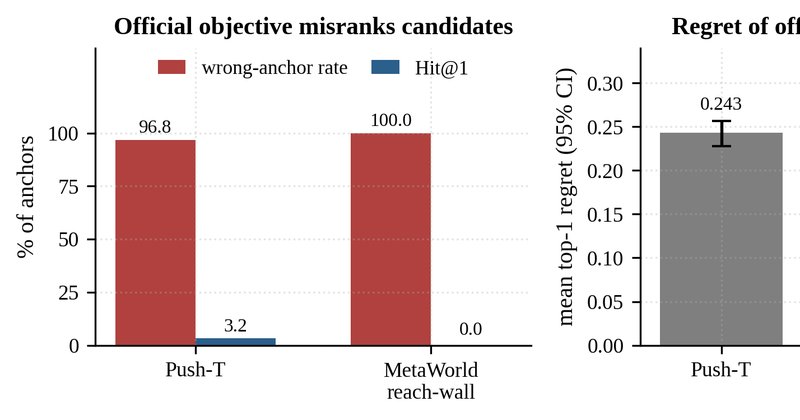
ARC-Bench expõe falha de ranking em world models JEPA congelados

ARC-Bench expõe falha de ranking em world models JEPA congelados

O ARC-Bench, novo protocolo de avaliação, auditou checkpoints oficiais de JEPA-WM e descobriu que o candidato de ação mais bem pontuado é quase sempre subótimo, em manipulação e em labirintos. O replanejamento em ciclo fechado esconde a falha e infla as taxas de sucesso.

Por Redação Mapa Paper10 set
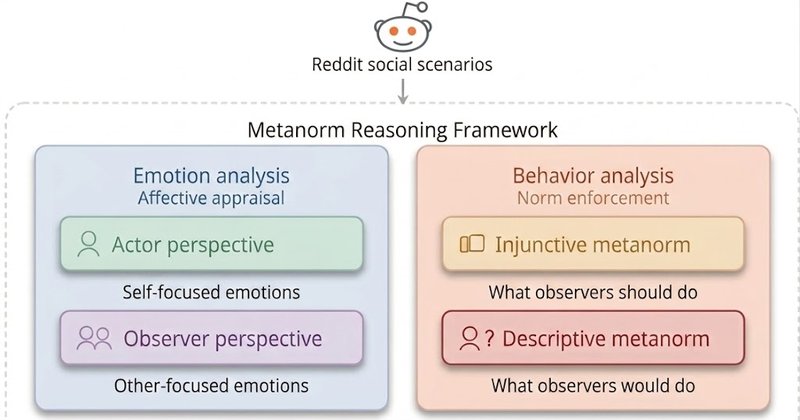
Estudo testa metanormas em LLMs e revela viés punitivo

Estudo testa metanormas em LLMs e revela viés punitivo

Pesquisa do arXiv apresenta o framework de metanormas e o dataset NormReact, com 450 cenários de violação de normas. Em seis modelos testados, os LLMs previram mais punição do que humanos e pioraram o alinhamento conforme a distância social aumentou.

Por Redação Mapa Paper10 set