
Busca semântica do LinkedIn ganha novo framework com GPU e sobe precisão
O LinkedIn publicou um novo framework de busca semântica com GPU que elevou a precisão de consultas exploratórias de 63,7% para 79,0% em teste A/B com usuários reais.
O LinkedIn publicou um novo framework de busca semântica com GPU que elevou a precisão de consultas exploratórias de 63,7% para 79,0% em teste A/B com usuários reais.
Estudo no arXiv apresenta o Oculi, plataforma conversacional que automatiza a análise de risco de crédito com agentes de IA. Em teste com carteira de hipotecas de mais de 200 variáveis, a ferramenta encontrou segmentos de risco que passariam despercebidos na exploração manual.
Pesquisa do arXiv converte o Qwen3.5-0.8B no modelo ternário Cloe, que preserva 77,1% da performance média em dez tarefas, mas perde conhecimento factual especializado.
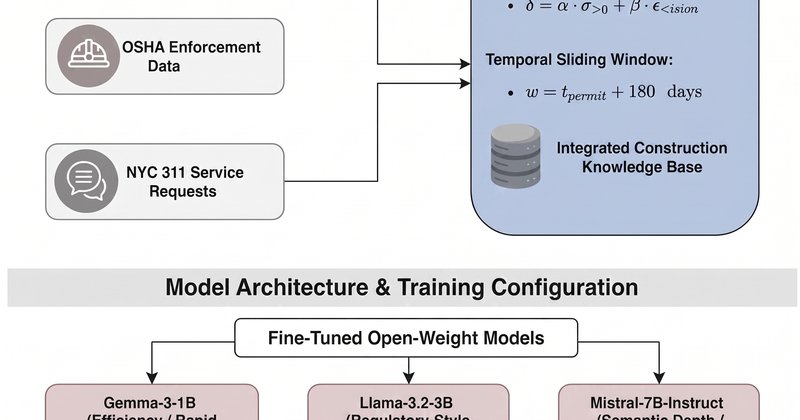
Pesquisa do arXiv descreve o PermitGPT, pipeline de IA generativa que unifica previsão de riscos, licenças e impacto comunitário na construção civil, usando 90 mil registros de Nova York e três modelos de linguagem abertos.
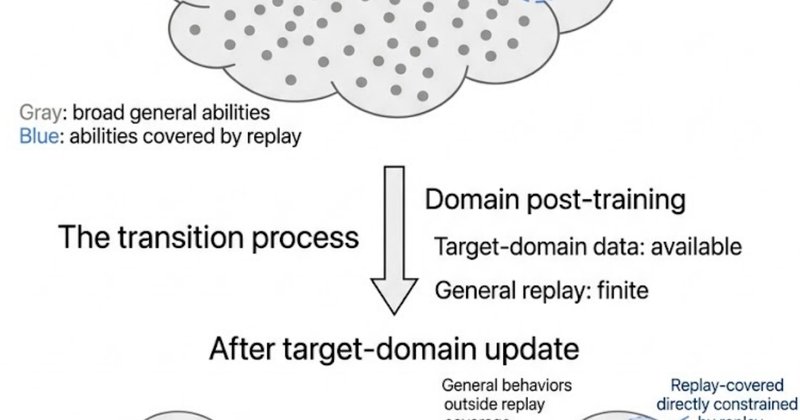
Pesquisa do arXiv mostra que a técnica SSTD permite treinar um modelo de IA para tarefas específicas sem perder suas capacidades gerais, aumentando a pontuação em testes em até 5 pontos.
Um estudo do arXiv propõe o MAGG, framework que governa a construção de knowledge graphs para agentes de IA. No MuSiQue, o MAGG supera o Microsoft GraphRAG por 9,0 pontos de exact-match; no SciERC, o strict triple F1 sobe 47%.
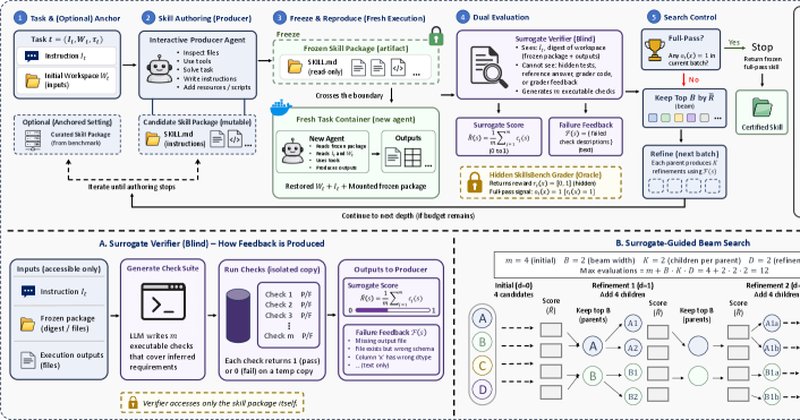
O framework reSolve, descrito em artigo no arXiv, fez um modelo barato de IA auto-evoluir skills até 74,9% de mean-of-3, superando em 14,8 pontos a curadoria humana e batendo o melhor resultado oficial do GPT-5.5/OpenHands.
Pesquisadores propuseram um algoritmo que aprende preferências sobre resultados de transplantes de coração, alcançando 0,95 de eficiência ante 0,54 da política atual.
Pesquisadores lançaram o RegDivergence-101, um benchmark com 101 pares de exigências da FDA e da EMA para classificar concordância, divergência ou silêncio regulatório. No teste, o Claude Haiku alcançou 0,830 de macro-F1, superando métodos de grafo e lexical.
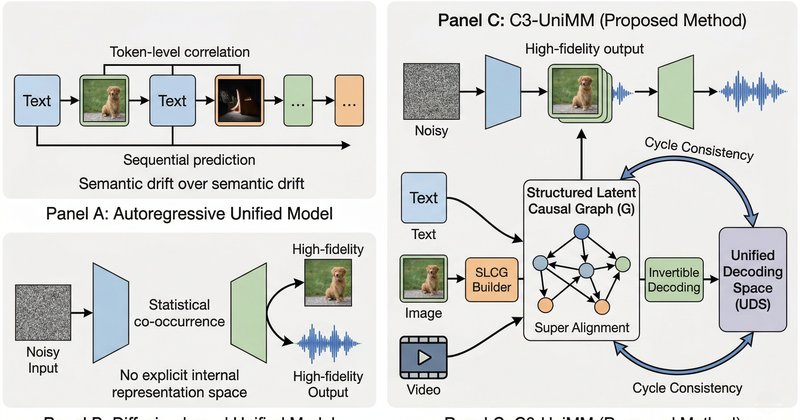
Pesquisadores publicaram no arXiv o C3-UniMM, um framework que propõe usar um grafo causal estruturado para unificar compreensão e geração multimodal, prometendo superar os modelos atuais.