
Infostealers sequestram sessões do Claude e driblam 2FA
A Anthropic informou usuários sobre infostealers que reutilizaram cookies de sessão do Claude, pulando a validação de 2FA e causando consumo indevido das assinaturas pessoais.
A Anthropic informou usuários sobre infostealers que reutilizaram cookies de sessão do Claude, pulando a validação de 2FA e causando consumo indevido das assinaturas pessoais.
Google DeepMind lança Fairwind Program, que combina o modelo Gemini 3.8 Flash Cyber com a ferramenta CodeMender para encontrar e corrigir vulnerabilidades em minutos, reduzindo custos e tempo de exposição para governos e empresas.
O modelo de engenharia forward-deployed, central na IA empresarial, só agrega valor se transformar aprendizado em produto reutilizável. Um artigo do VentureBeat explica como avaliar se o FDE é vantagem competitiva ou apenas custo de entrega.
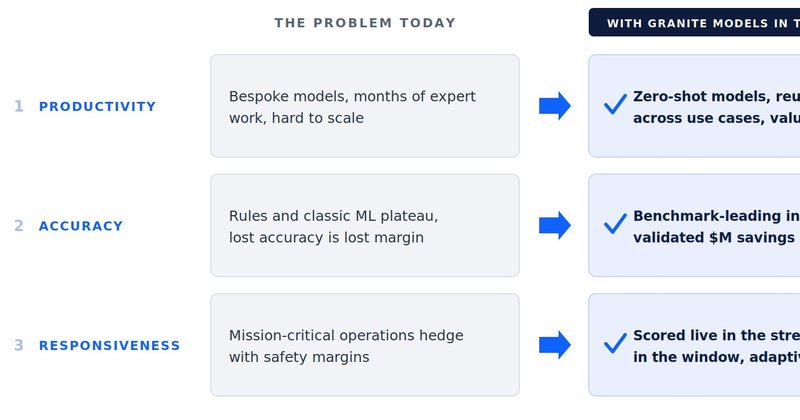
A IBM integrou seus modelos de séries temporais à plataforma Confluent, permitindo previsão e detecção de anomalias em tempo real sem equipes de ciência de dados. Ganhos de produtividade de 5 a 10 vezes são relatados.
Um estudo submetido ao arXiv em 2026 define o número R_AI para saber quando o uso de IA na criação de novas IAs cria um ciclo de auto-amplificação. O modelo mostra que a auto-amplificação pode existir antes de ficar visível e que o ecossistema coletivo pode ser crítico mesmo quando nenhuma empresa individual é.
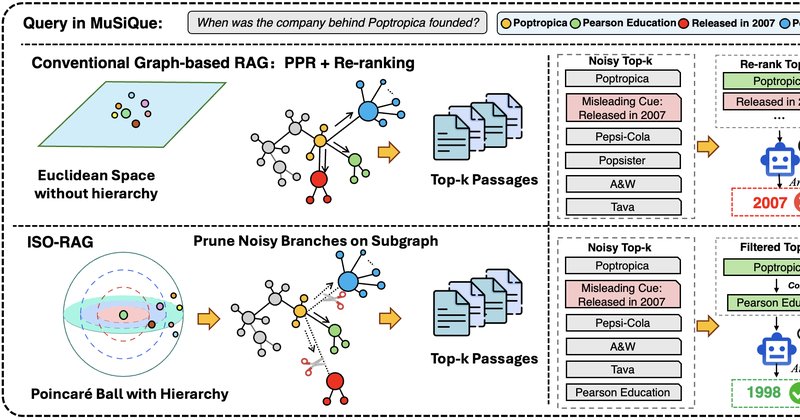
O ISO-RAG, framework de Retrieval-Augmented Generation com geometria hiperbólica, alcançou 10% a mais de recall e 4,3% de ganho em exact match em benchmarks multi-hop QA, eliminando a latência de travessias globais de grafos.
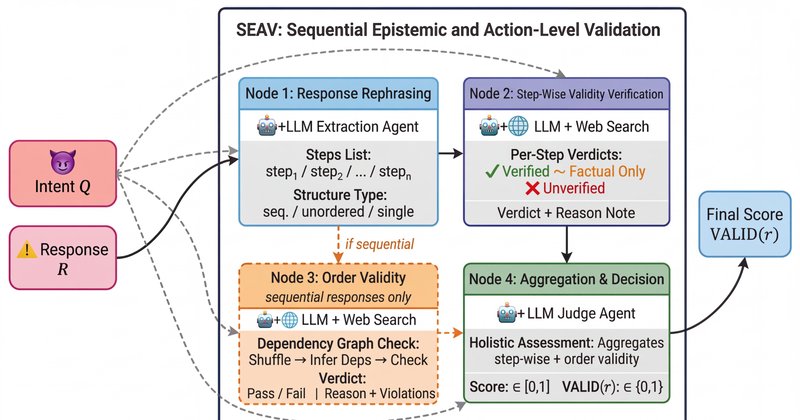
Estudo do arXiv apresenta SEAV, framework que reduz falsos positivos em testes de jailbreak de LLMs em até 14,9 pontos percentuais, reclassificando até 51% dos sucessos anteriores como inválidos.
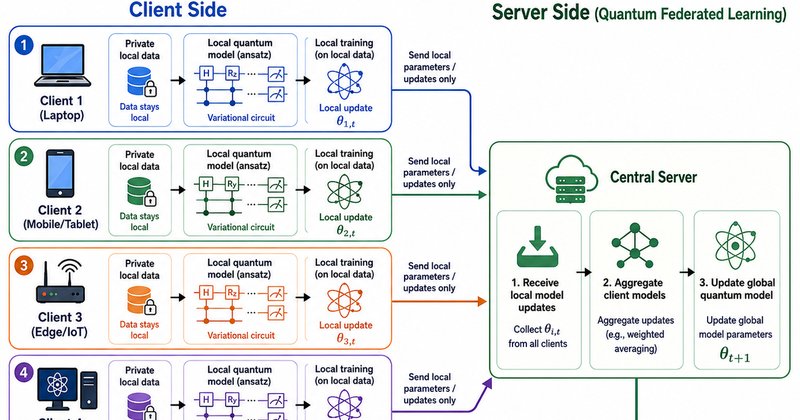
Estudo propõe método de agregação estável para aprendizado federado quântico, validado em máquinas IBM e em dados médicos e financeiros, com menor volatilidade e precisão competitiva.
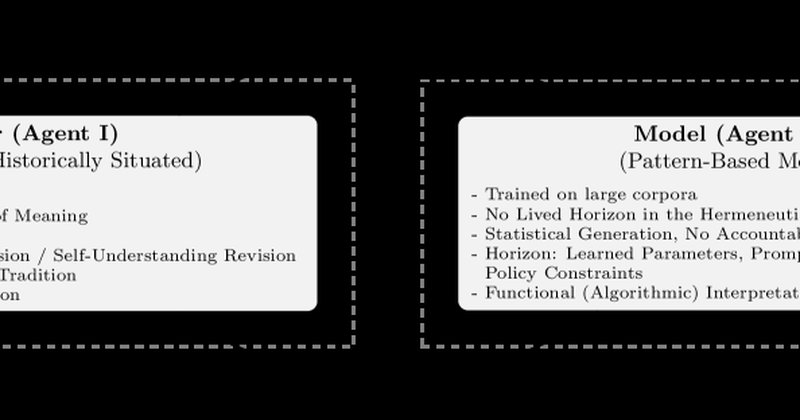
Pesquisa no arXiv define o conceito de 'interpretive misplacement' e propõe princípios de design para que humanos e IA atuem juntos na interpretação de textos, evitando perda de responsabilidade em áreas críticas.
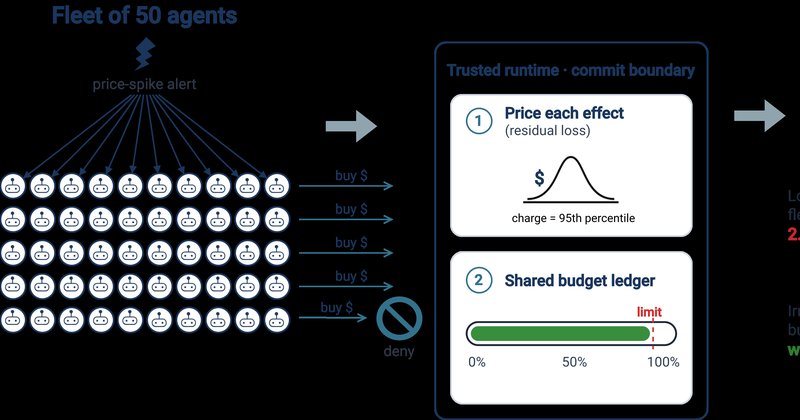
Pesquisa propõe orçamento de irreversibilidade para impedir que frotas de agentes de IA causem danos cumulativos. Estudo mostra que controles atuais permitem estouros de até 48 vezes o limite de risco.