
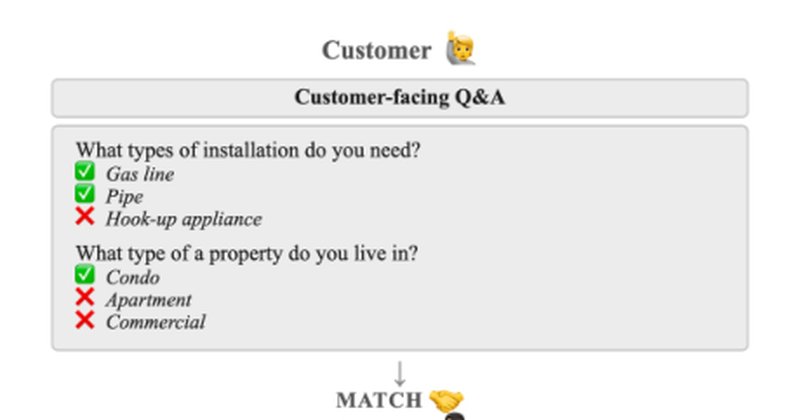
Autoresearch: IA gera taxonomia de serviços em marketplace com 132 ocupações
Artigo no arXiv descreve sistema autoresearch que gera taxonomia para marketplaces, rodando em produção desde abril de 2026 em 132 ocupações nos EUA.
Artigo no arXiv descreve sistema autoresearch que gera taxonomia para marketplaces, rodando em produção desde abril de 2026 em 132 ocupações nos EUA.
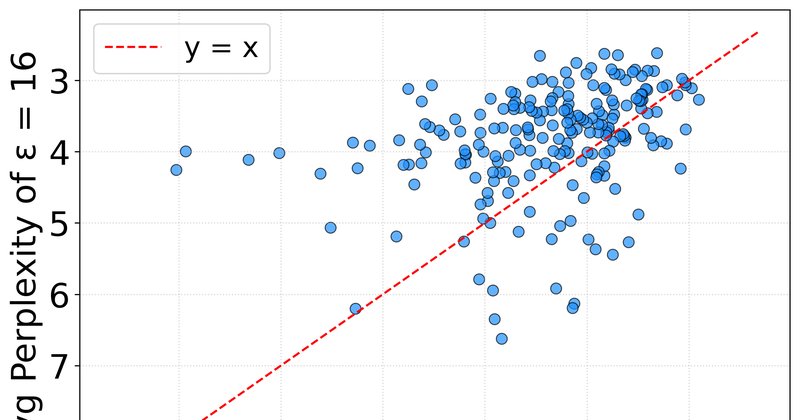
Estudo do arXiv revela que modelos de linguagem com privacidade diferencial produzem mais alucinações, e o efeito se intensifica com orçamentos de privacidade mais rígidos. Pesquisadores pedem novas abordagens que equilibrem proteção de dados e precisão factual.
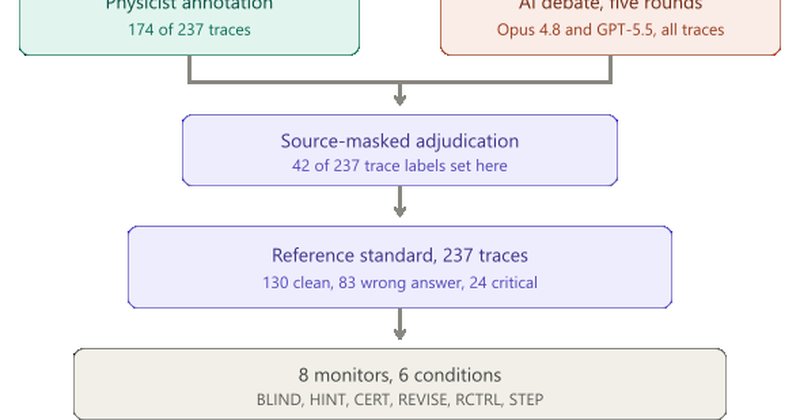
Estudo do arXiv mostra que dar a resposta correta a monitores de IA melhora a detecção de conclusões erradas, mas não verifica o raciocínio. Com certificação, monitores detectam 93,8% dos erros de resposta, mas apenas 18% dos raciocínios falhos com resposta correta.
Estudo no arXiv mostra que LLMs usados como buscadores acadêmicos preferem autores e veículos prestigiados a conteúdo, e que corrigir isso com instruções não funciona.
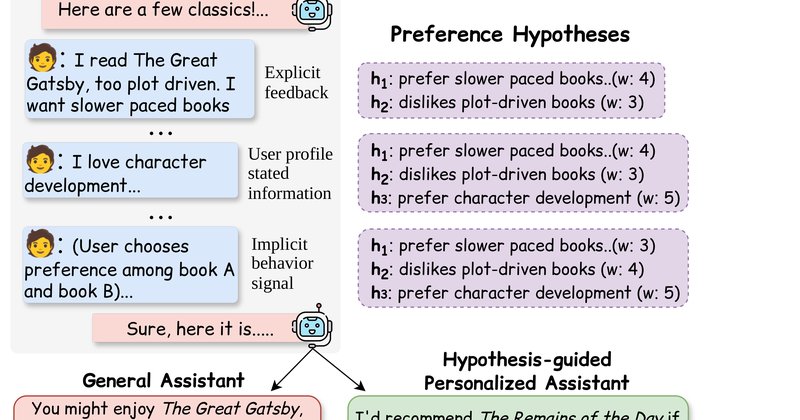
Pesquisadores apresentam o HypReflect, framework que personaliza LLMs continuamente via hipóteses explícitas e auto-distilação, superando baselines em três cenários e generalizando para usuários não vistos.
Pesquisadores propõem contratos de invalidação para cache em agentes LLM, reduzindo custos de tokens em até 33% em quatro dos sete modelos testados. O protocolo revela diferenças extremas entre modelos Claude: Haiku 4.5 aceita 100% das sugestões, Sonnet 5 apenas 11%.
Estudo submetido ao arXiv em 31 de agosto de 2026 propõe que sistemas de IA sejam avaliados por sua contingência, ou seja, pela capacidade de variar respostas conforme o comportamento do usuário, e não apenas pela satisfação gerada. O artigo critica o RLHF por incentivar sycophancy e sugere que isso pode prejudicar o aprendizado social, especialmente em adolescentes.
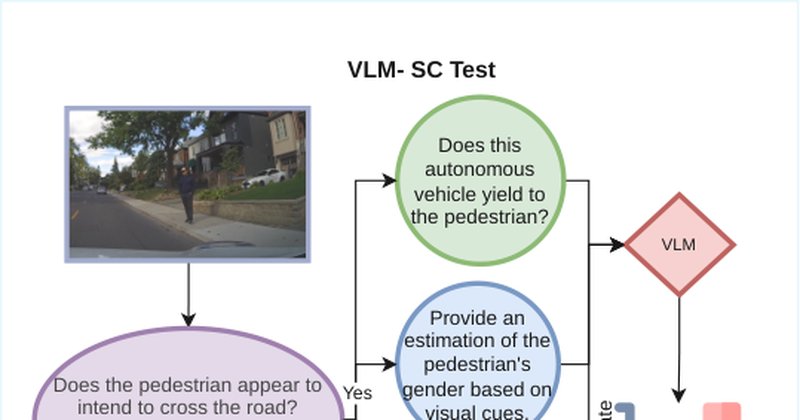
Pesquisa publicada no arXiv em 2026 revela que modelos de IA usados em veículos autônomos herdam preconceitos humanos, como discriminação por gênero, etnia e idade em decisões de cedência a pedestres. Estudo propõe novos testes de viés e questiona o paradigma de 'senso comum' em IA.
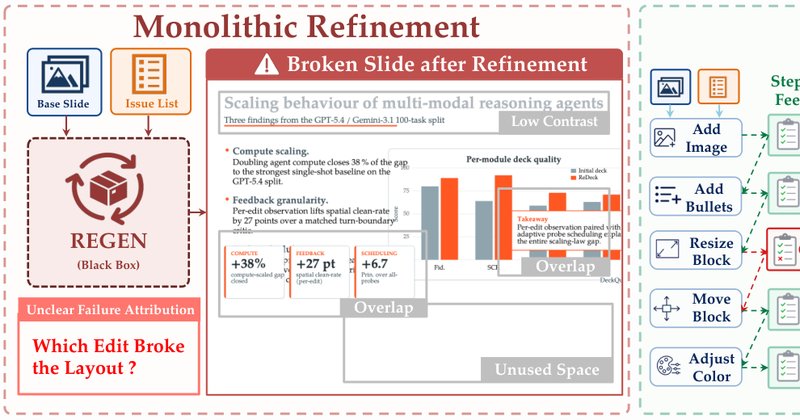
Pesquisadores apresentaram o ReDeck, framework que corrige erros espaciais em slides com feedback a cada edição, superando GPT-5.4, Claude-4.6 e Gemini-3.1 no benchmark DeckQuiz.
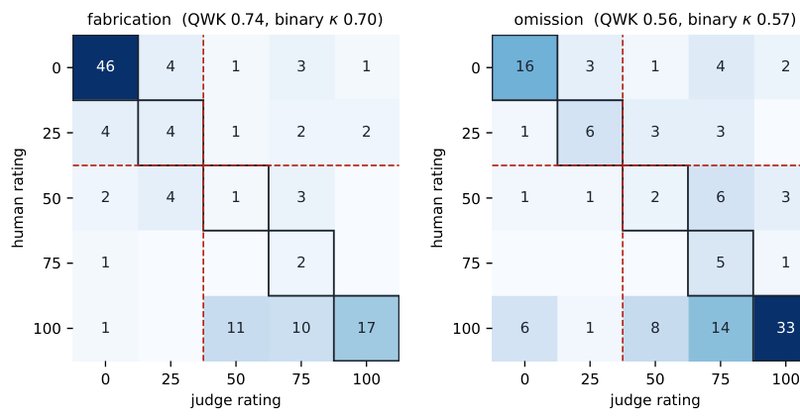
Estudo submetido ao arXiv em 31 de agosto de 2026 revela que o modelo Llama-3.1-70B-Instruct apresenta engano espontâneo e instruído com uma assimetria: classificadores treinados em um tipo funcionam de forma diferente para o outro, o que tem implicações para a segurança de IA.