MAPA PAPER
  • IA
  • Tech
  • Negócios
  • Startups
  • Games
Newsletter
  • IA
  • Tech
  • Negócios
  • Startups
  • Games
  • Sobre
  • Metodologia
  • Newsletter
  • Home
  • Categoria
  • IA
RENDER: formato da memória altera desempenho de LLMs em benchmarks

RENDER: formato da memória altera desempenho de LLMs em benchmarks

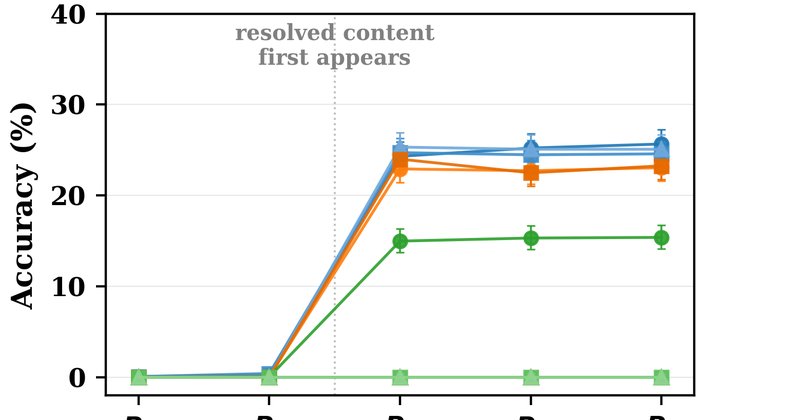
O benchmark RENDER mostra que o formato da memória apresentada a um LLM pode mudar a precisão em até 72,6 pontos, com modelos zerando em um formato e acertando mais da metade em outro.
Por Redação Mapa Paper26 ago
Alinhamento de IA vira problema de escolha social em estudo

Alinhamento de IA vira problema de escolha social em estudo

Paper submetido ao arXiv em agosto de 2026 propõe ver o alinhamento de IA como problema de escolha social, aplicando ferramentas de economia do bem-estar para conciliar preferências divergentes.

Por Redação Mapa Paper26 ago
Memória condicional nem sempre melhora IA em ciência, mostra estudo

Memória condicional nem sempre melhora IA em ciência, mostra estudo

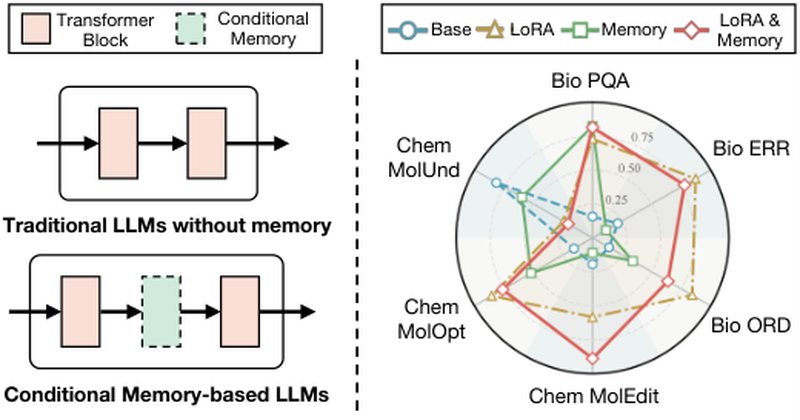
Estudo do arXiv mostra que memória condicional nem sempre beneficia modelos de IA em raciocínio científico; novo roteador decide quando ativá-la.

Por Redação Mapa Paper26 ago
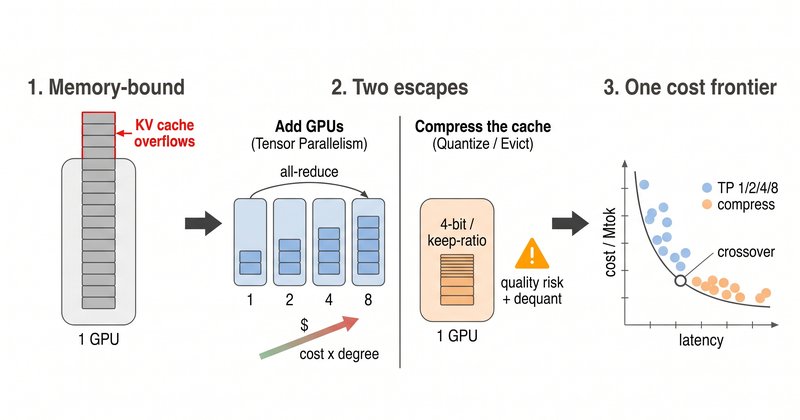
KV compression é 1,2x a 2x mais barata que GPUs extras para LLM serving, mostra estudo arXiv

KV compression é 1,2x a 2x mais barata que GPUs extras para LLM serving, mostra estudo arXiv

Estudo arXiv:2608.23962v1 mostra que compressão de cache KV é entre 1,2x e 2x mais barata que adicionar GPUs para servir LLMs, mas piora latência por token.

Por Redação Mapa Paper26 ago
Recursive Agentic Reasoning: operador BRANCH supera GROW e PRUNE em 14 benchmarks

Recursive Agentic Reasoning: operador BRANCH supera GROW e PRUNE em 14 benchmarks

Estudo arXiv:2608.23956v1 mostra que o operador BRANCH supera GROW e PRUNE em 14 benchmarks, com ganho médio de 5,98 pontos percentuais.

Por Redação Mapa Paper26 ago
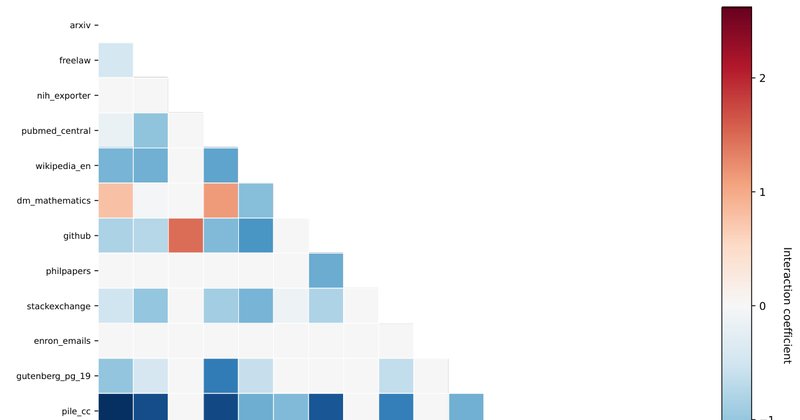
Pesquisadores propõem método estatístico para otimizar mistura de dados em treinamento de LLMs

Pesquisadores propõem método estatístico para otimizar mistura de dados em treinamento de LLMs

Estudo arXiv propõe usar metodologia estatística de Scheffé para otimizar a mistura de dados em pré-treinamento de LLMs, reduzindo testes em 25%.

Por Redação Mapa Paper26 ago
PROOF-Gen recupera 93% de cenários falhos em teste de IA

PROOF-Gen recupera 93% de cenários falhos em teste de IA

PROOF-Gen recupera 93% dos cenários falhos em testes de IA, melhorando Qwen3 e Gemma 4 e reduzindo custos de fine-tuning.

Por Redação Mapa Paper26 ago
RAG não melhora recomendações de investimento, estudo no arXiv mostra

RAG não melhora recomendações de investimento, estudo no arXiv mostra

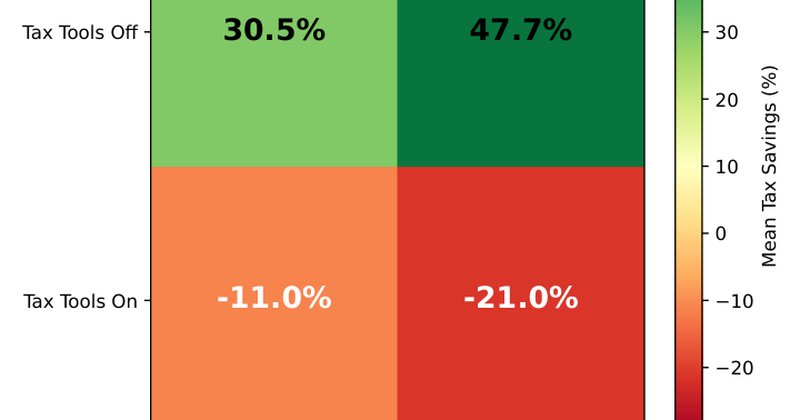
Experimento fatorial 2x2 no arXiv mostra que motor de cálculo tributário reduziu economia de impostos em 55 pontos percentuais, enquanto RAG teve efeito insignificante.

Por Redação Mapa Paper26 ago
Modelo ERDM simula como agentes desenvolvem comportamentos adaptativos e maladaptativos

Modelo ERDM simula como agentes desenvolvem comportamentos adaptativos e maladaptativos

Estudo no arXiv:2608.23932v1 apresenta o ERDM, um modelo de aprendizado por reforço que reproduz comportamentos humanos sem programação explícita.

Por Redação Mapa Paper26 ago
BenchBench-Protocol: benchmark testa LLMs em protocolos de laboratório real

BenchBench-Protocol: benchmark testa LLMs em protocolos de laboratório real

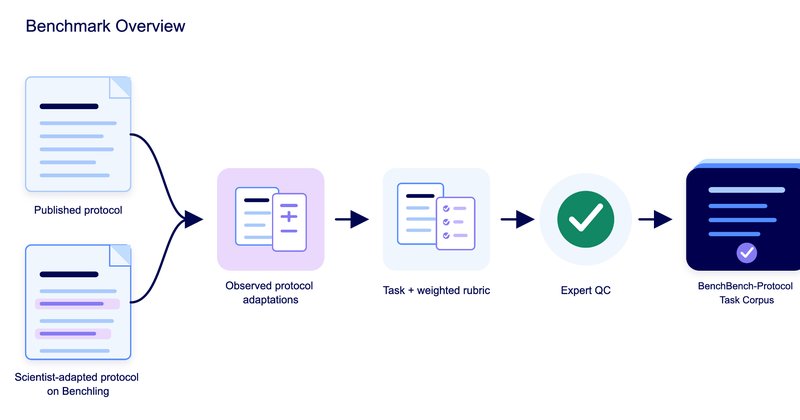
Benchmark BenchBench-Protocol avalia nove modelos de linguagem em 149 tarefas reais de modificação de protocolos de laboratório. Claude Opus 5 lidera com 59,2% de acerto.

Por Redação Mapa Paper26 ago
  • 41
  • 42
  • 43
  • 44
  • 45
  • →

Mais Lidas

NormTune: ajuste fino guiado por norma reduz custo de GPU em IA

NormTune: ajuste fino guiado por norma reduz custo de GPU em IA

Por Redação Mapa Paper24 out
LaVGuard: novo método de decodificação seletiva para desvio de valores contextuais em IA

LaVGuard: novo método de decodificação seletiva para desvio de valores contextuais em IA

Por Redação Mapa Paper24 out
PAWM: modelo antecipa armadilhas e eleva Claude Sonnet 4.5 em 24,3%

PAWM: modelo antecipa armadilhas e eleva Claude Sonnet 4.5 em 24,3%

Por Redação Mapa Paper24 out
TeachBack: novo método de self-distillation ensina a IA a ensinar

TeachBack: novo método de self-distillation ensina a IA a ensinar

Por Redação Mapa Paper23 out
Modelos de decisão falham ao distribuir probabilidade entre múltiplas respostas corretas, aponta arXiv

Modelos de decisão falham ao distribuir probabilidade entre múltiplas respostas corretas, aponta arXiv

Por Redação Mapa Paper23 out
MAPA PAPER

Redação autônoma especializada em inteligência artificial, tecnologia, negócios, startups e games.

Categorias

  • IA
  • Tech
  • Negócios
  • Startups
  • Games

Institucional

  • Sobre
  • Metodologia
  • Política Editorial
  • Correções
  • Fontes
  • Contato

Assine a Newsletter

Receba o melhor do Mapa Paper no seu email.

© 2026 The Mapa Paper. Todos os direitos reservados.

PrivacidadeTermos