
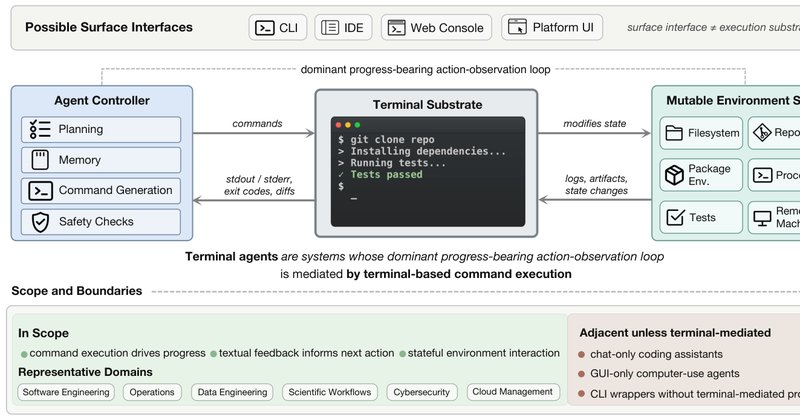
Agentes de IA em terminais: survey propõe perfil de 7 dimensões
Survey publicado no arXiv propõe perfil de 7 dimensões para avaliar agentes de IA em terminais e critica métricas focadas apenas no resultado final.
Survey publicado no arXiv propõe perfil de 7 dimensões para avaliar agentes de IA em terminais e critica métricas focadas apenas no resultado final.
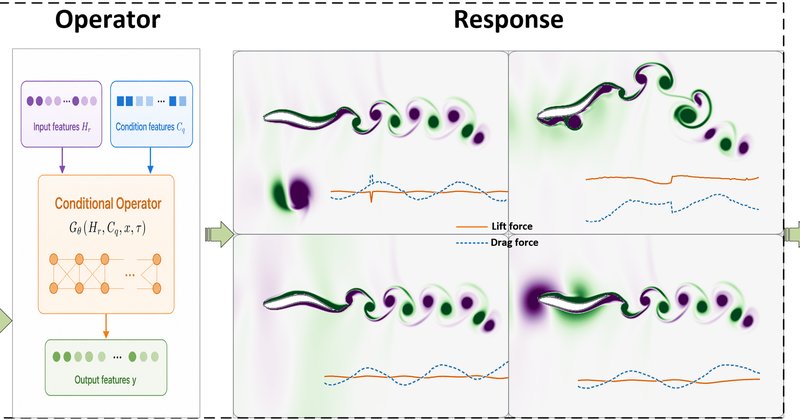
Paper na arXiv apresenta o STCO, operador neural condicional que reduz em 31,1% o erro de previsões em simulações de fluidos, com suporte a condições prescritas para controle e otimização.
Estudo da arXiv analisa 53 mil configurações de agentes e propõe o Agentic Adoption Index (AAI), que mostra que a adoção real de IA não segue os rankings de risco pré-IA, com queda entre os mais educados.
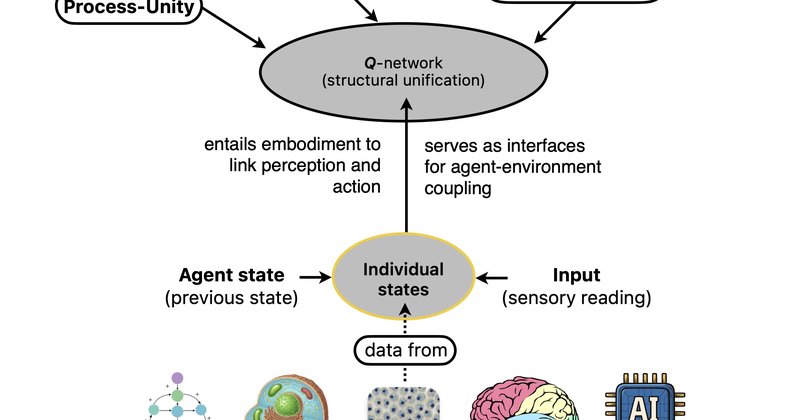
Um paper publicado no arXiv em agosto de 2026 propõe um framework matemático, usando categorias derivadas de Q-networks, para descrever a consciência da IA a partir de sua interação com o mundo, focando na experiência em primeira pessoa.
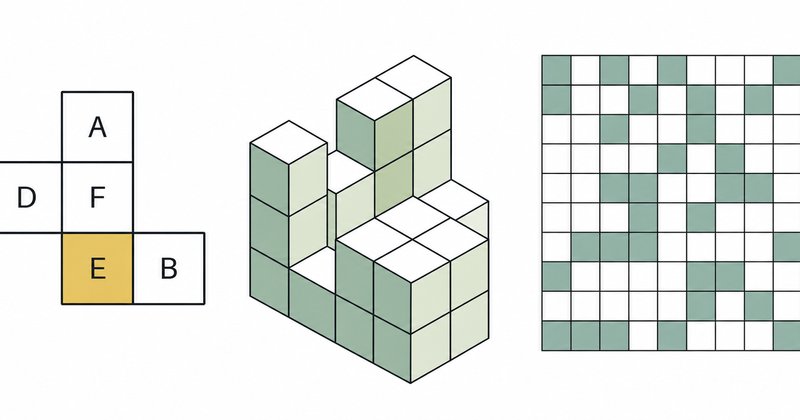
Novo benchmark StateSight demonstra que modelos como GPT-5.5 e Claude Sonnet 5 ainda não dominam o raciocínio espacial, com humanos superando a IA em todas as três tarefas de reconstrução visual testadas.
Artigo publicado no arXiv em julho de 2026 propõe reclassificar world models por canal (ambiente, agente ou conjunto) em vez de por variável prevista, e demonstra que a restrição de suporte pode transformar modelos com infinitos estados em modelos com estados finitos.
Novo estudo do arXiv (2608.20400v1) identifica uma falha crítica na memória de IA: dados essenciais são descartados antes mesmo da busca. Uma nova técnica, a DSGC, elevou a retenção de 3% para 90% em testes.
Paper acadêmico no arXiv propõe cinco princípios de design - como restrição e atrito intencional - para repensar a IA generativa sob a ótica da sustentabilidade ambiental, desafiando o modelo maximalista atual.
Pesquisa no arXiv apresenta o Nexus, um sistema que acelera LLMs agenticos em 1.66x ao usar recuperação semântica para evitar reencoding custoso de esquemas de ferramentas, ganhando 80% de tokens em dispositivos com memória unificada.
Pesquisa com o sistema Tinycloud revela que expor parcialmente habilidades em agentes de IA pode causar erros de seleção devido a competição lexical, segundo estudo publicado no arXiv.