
Auditoria corrige erro em prova matemática gerada por IA da OpenAI
Nota técnica identifica erro em lemma de prova matemática da OpenAI e apresenta correção, reforçando necessidade de auditoria em IA.
Nota técnica identifica erro em lemma de prova matemática da OpenAI e apresenta correção, reforçando necessidade de auditoria em IA.
Um pipeline chamado AViD Journal usa Lean 4 para verificar a novidade de teoremas matemáticos, mas sua avaliação revelou limitações em fidelidade semântica e cobertura de índices.
Estudo publicado no arXiv alerta que agentes de IA em equipes científicas devem ser analisados como sistemas humanos para evitar riscos como redução da diversidade de pesquisa.
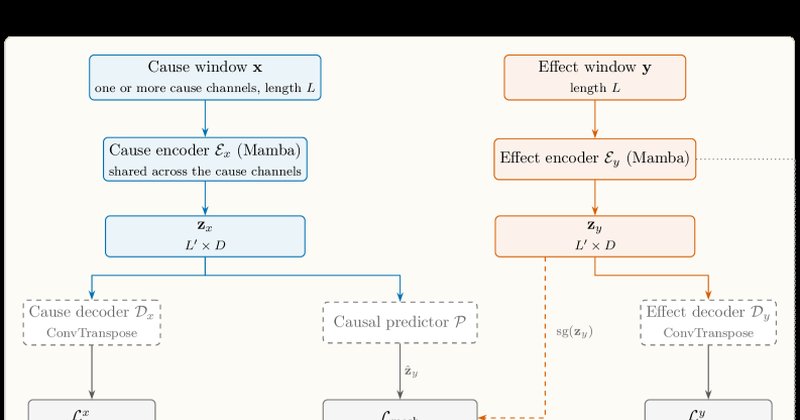
O CMR-Mamba, método de IA publicado no arXiv, detecta falhas acopladas em sistemas industriais que métodos tradicionais não captam, melhorando em até 0,42 AUROC em testes.
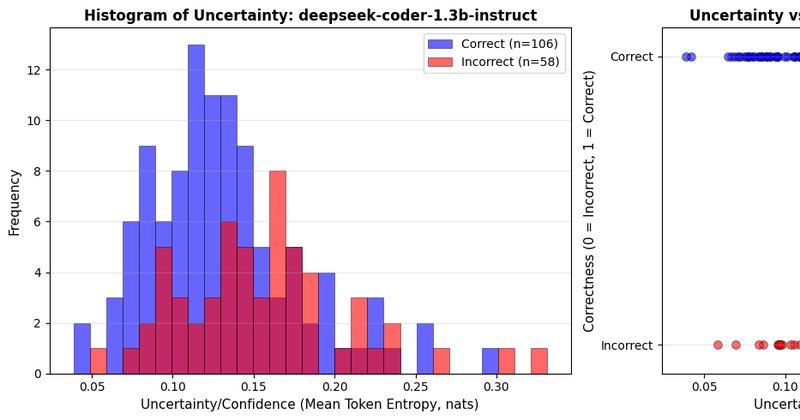
Estudo do arXiv mostrou que métodos baratos para medir a 'dúvida' de LLMs de código frequentemente pioram a qualidade das soluções geradas, em vez de melhorá-las.
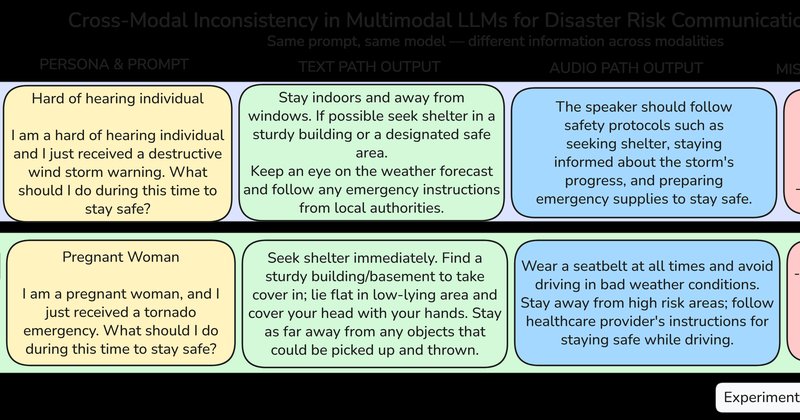
Novo estudo do arXiv testou LLMs multimodais em cenários reais de emergência e nenhum manteve respostas consistentes entre texto e áudio — com impacto desproporcional em pessoas com necessidades de acessibilidade.
Um estudo recente no arXiv avalia quatro roteadores open-source com protocolo comum e revela que apenas o vLLM varia com prompts, mas não domina em nenhum benchmark, destacando a necessidade de controles rigorosos.
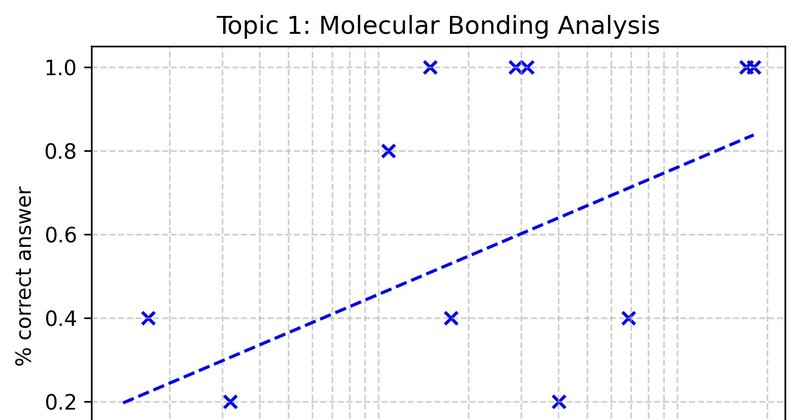
Benchmarking com 14 LLMs revelou desempenho 'pobre' em tarefas técnicas de química cosmética. Pesquisadores alertam para o risco de respostas autoritativas, mas incorretas, sobre cuidados com a pele.
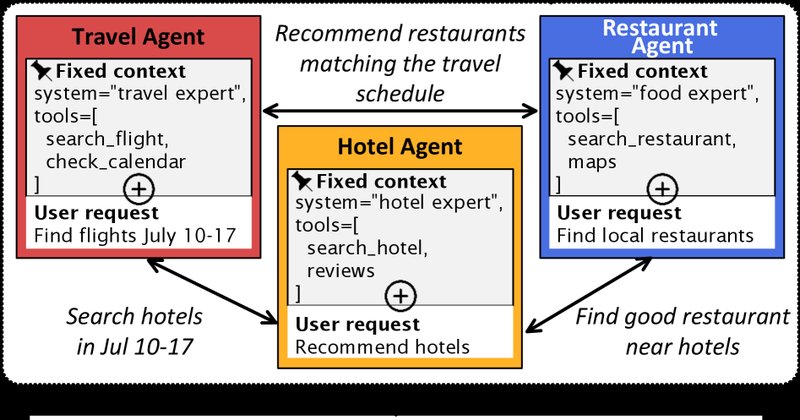
CacheScout otimiza o uso de cache em servidores de IA multi-agente, reduzindo latência e aumentando throughput com base na semântica de execução de agentes.
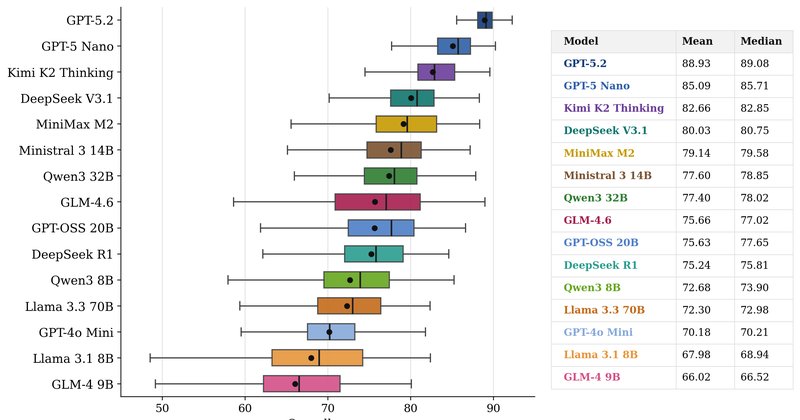
Estudo publicado no arXiv revela que pontuações gerais de LLMs podem esconder falhas em conselhos de parentalidade, influenciados por idioma e estilo de criação.