Auditoria XAI revela explicações enganosas mesmo em modelos com AUC acima de 0,99
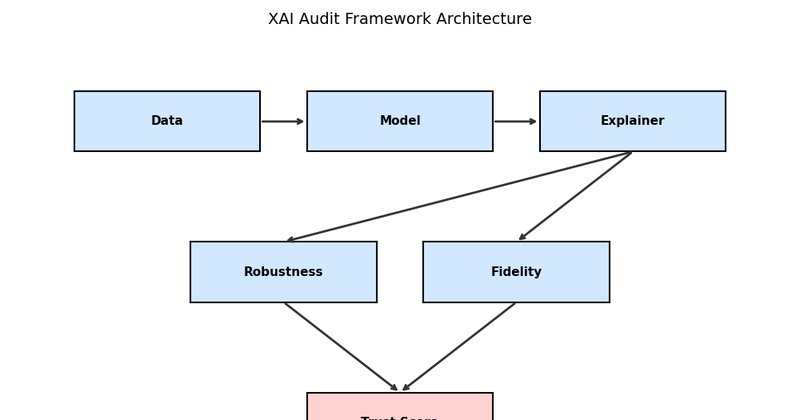
Estudo publicado no arXiv propõe framework para auditar robustez e fidelidade de explicadores de IA como SHAP e LIME, revelando que modelos com AUC acima de 0,99 podem gerar explicações enganosas.