
MemoryLake lidera comparativo de backends de memória para agentes de IA
Pesquisa publicada no arXiv mostra que o MemoryLake teve desempenho superior em três áreas do benchmark MemoryArena, mas os resultados variam conforme o tipo de tarefa.
Pesquisa publicada no arXiv mostra que o MemoryLake teve desempenho superior em três áreas do benchmark MemoryArena, mas os resultados variam conforme o tipo de tarefa.
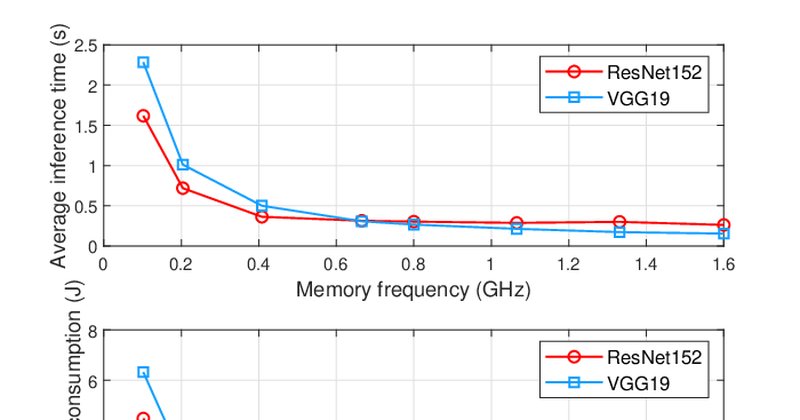
Um novo algoritmo otimiza memória e frequência para reduzir consumo de energia em inference de DNN em dispositivos móveis, com ganhos de até 10,4% em eficiência.
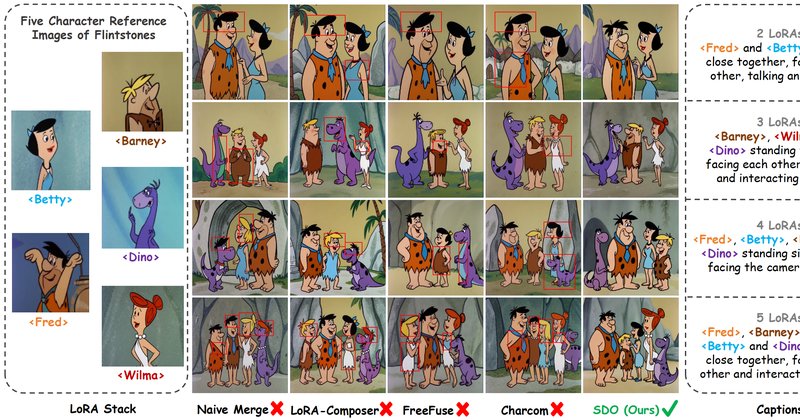
Novo operador publicado no arXiv resolve conflitos de subespaços que causam mixing de identidade na composição de múltiplos adapters em modelos de difusão, melhorando fidelidade e estabilidade em gerações complexas.
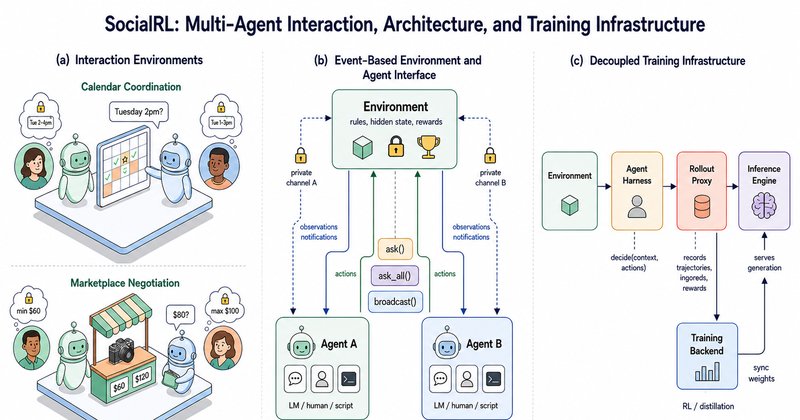
Um modelo de linguagem com apenas 4 bilhões de parâmetros, treinado com a técnica SocialRL, está superando gigantes como o GPT-5.1 em tarefas de negociação, provando que IAs menores podem ser strategicamente competitivas.
Novo método FLARE MCMC usa aproximações de fidelidade variável para melhorar a eficiência de Markov Chain Monte Carlo em simulações científicas, reduzindo custo computacional em hidrologia e cosmologia.
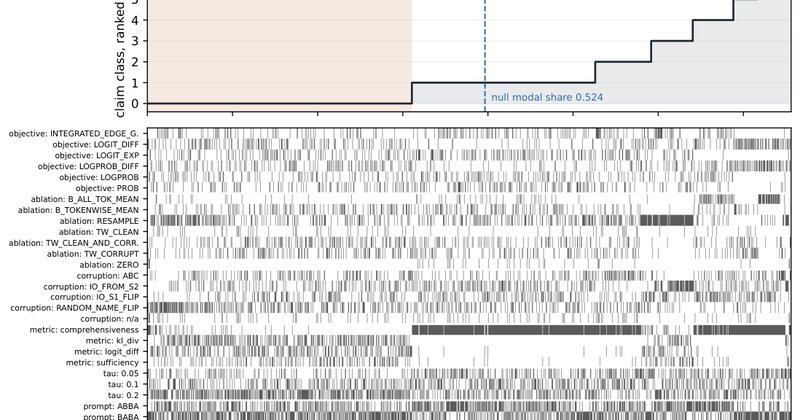
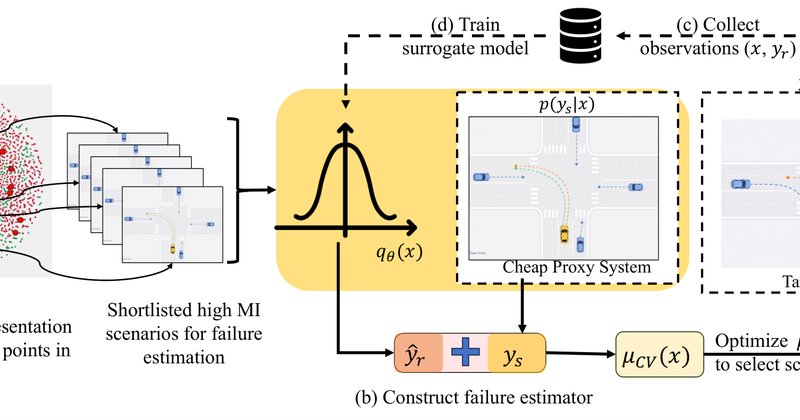
Novo método publicado no arXiv combina dados de simuladores com testes reais limitados para encontrar até o dobro de falhas em sistemas autônomos, superando técnicas tradicionais de amostragem e aprendizado ativo.
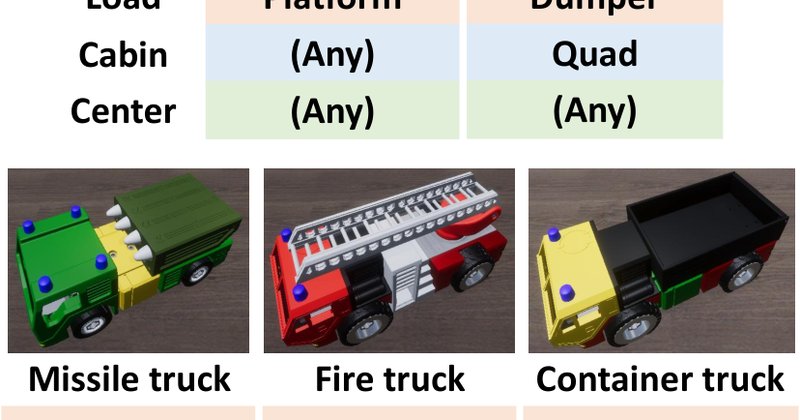
Pesquisa publicada no arXiv mostra que agentes de IA que aprendem a montar estruturas novas através de conversas em linguagem natural adaptam-se de forma mais eficiente do que métodos tradicionais baseados em demonstrações.
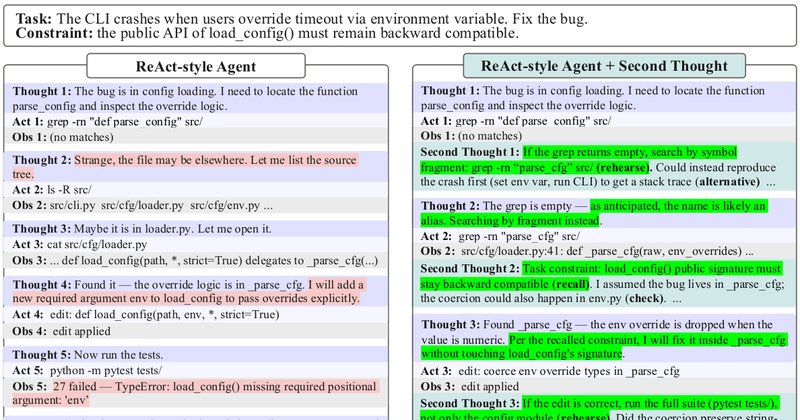
Framework de inferência paralleliza o raciocínio de agentes LLM durante a espera por observações, reduzindo decodificação em até 43% sem perder acurácia em testes preliminares.
MOOSEDev usa grafo de conhecimento para dar memória estruturada a agentes de código, superando ferramentas vetoriais em consultas complexas com até 100% de acerto.