A resposta não é o argumento: limite do monitoramento de IA

A resposta não é o argumento: limite do monitoramento de IA

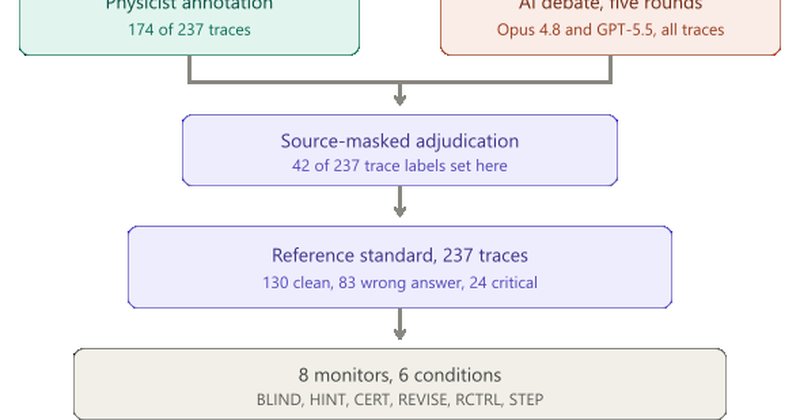
Estudo do arXiv mostra que dar a resposta correta a monitores de IA melhora a detecção de conclusões erradas, mas não verifica o raciocínio. Com certificação, monitores detectam 93,8% dos erros de resposta, mas apenas 18% dos raciocínios falhos com resposta correta.
Por Redação Mapa Paper2 set
Protocolo de invalidação de cache corta custos em agentes LLM

Protocolo de invalidação de cache corta custos em agentes LLM

Pesquisadores propõem contratos de invalidação para cache em agentes LLM, reduzindo custos de tokens em até 33% em quatro dos sete modelos testados. O protocolo revela diferenças extremas entre modelos Claude: Haiku 4.5 aceita 100% das sugestões, Sonnet 5 apenas 11%.

Por Redação Mapa Paper2 set
IA precisa ser contingente, não apenas útil, propõe estudo

IA precisa ser contingente, não apenas útil, propõe estudo

Estudo submetido ao arXiv em 31 de agosto de 2026 propõe que sistemas de IA sejam avaliados por sua contingência, ou seja, pela capacidade de variar respostas conforme o comportamento do usuário, e não apenas pela satisfação gerada. O artigo critica o RLHF por incentivar sycophancy e sugere que isso pode prejudicar o aprendizado social, especialmente em adolescentes.

Por Redação Mapa Paper2 set
Pesquisa revela assimetria entre engano espontâneo e instruído em LLMs

Pesquisa revela assimetria entre engano espontâneo e instruído em LLMs

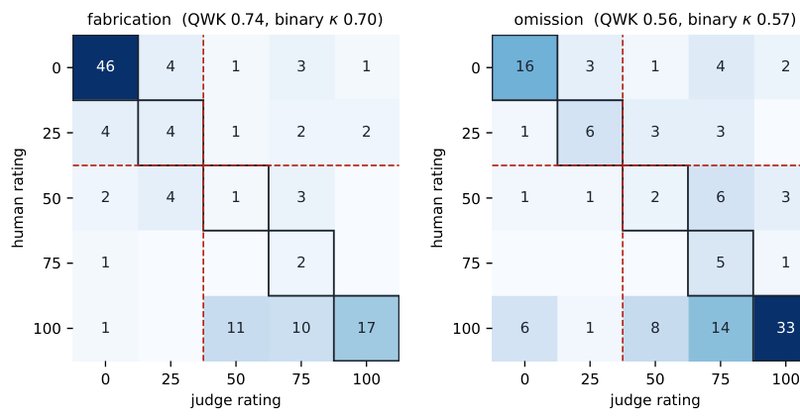
Estudo submetido ao arXiv em 31 de agosto de 2026 revela que o modelo Llama-3.1-70B-Instruct apresenta engano espontâneo e instruído com uma assimetria: classificadores treinados em um tipo funcionam de forma diferente para o outro, o que tem implicações para a segurança de IA.

Por Redação Mapa Paper2 set