
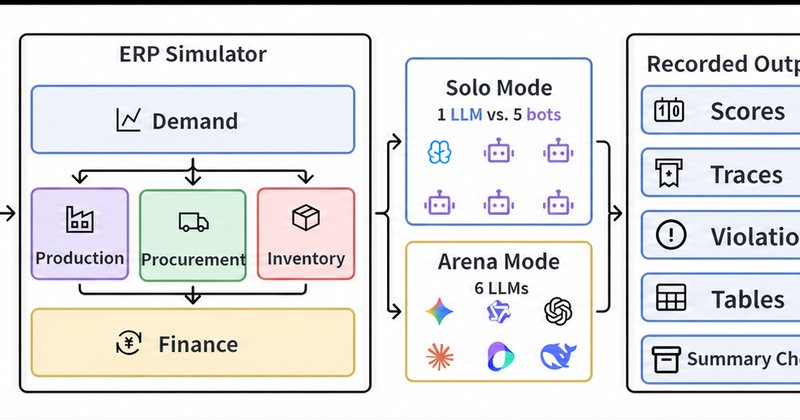
ERPBench: benchmark testa agentes de IA em decisões empresariais
Benchmark ERPBench, publicado no arXiv, mostra que DeepSeek lidera em cenário Solo e Gemini em Arena, com os mesmos 100 problemas apontando vencedor comum em apenas 21 casos.
Benchmark ERPBench, publicado no arXiv, mostra que DeepSeek lidera em cenário Solo e Gemini em Arena, com os mesmos 100 problemas apontando vencedor comum em apenas 21 casos.
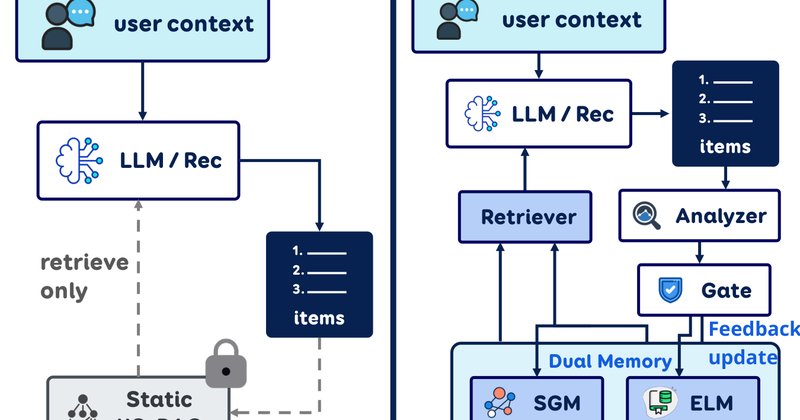
O CGM-Rec, framework de memória de grafos contínua publicado no arXiv em setembro de 2026, adapta sistemas de recomendação à mudança de intenção do usuário sem retreinar o modelo, com ganho de até 29,58% em HR@1 sobre o baseline de LLM mais forte no dataset Bundle.
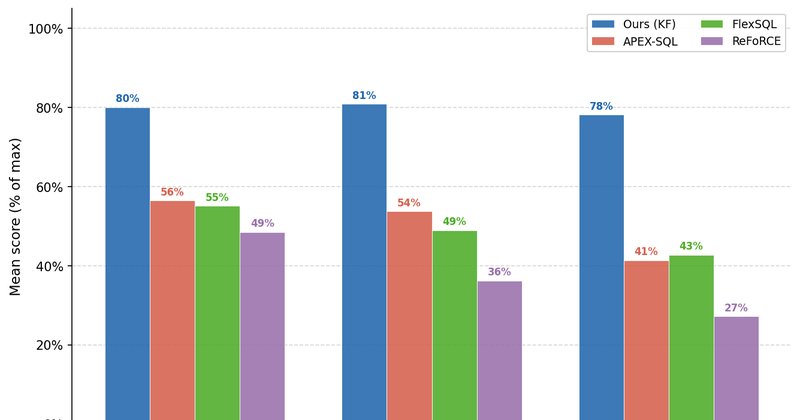
Paper publicado no arXiv em setembro de 2026 apresenta o benchmark DevRev NL2SQL, com 900 consultas verificadas sobre esquemas empresariais aninhados, e uma arquitetura agêntica consciente de custo que atinge 91,7% de acerto, 54,6 pontos acima do melhor concorrente.
Paper no arXiv apresenta o SiLR, método de admissão estrutural para agentes de LLM que recupera 21/21 episódios em Gym-ANM contra 0/21 de gates escalares e bloqueia ações fisicamente inseguras que os métodos tradicionais deixam passar.
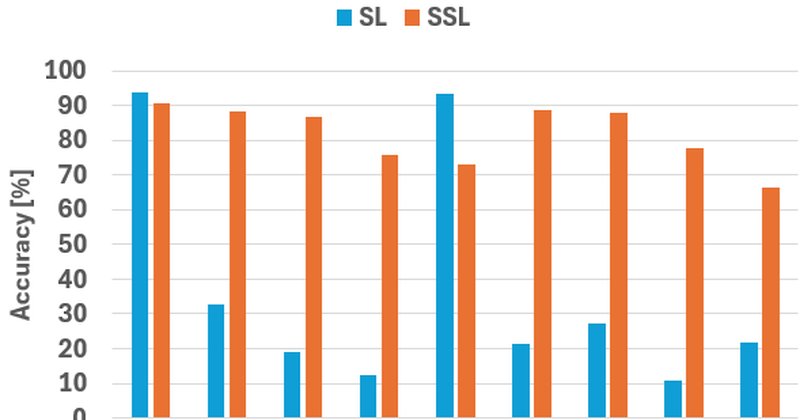
Artigo publicado no arXiv em 4 de setembro de 2026 apresenta o Imperfect Restoration Poisoning (IRP), método que envenena dados de treinamento de IA preservando a qualidade das imagens e superando o CUDA em oito baselines e cinco defesas testadas.
Estudo no arXiv audita 600 perguntas do HybridQA e mostra que o BM25 puro perde o objeto selecionado em 26,6% dos casos, enquanto a recuperação híbrida com reranking falha em apenas 1,0%. Pesquisadores lançam o Returned-Object Profile (ROP) para auditar handoffs em pipelines de IA.
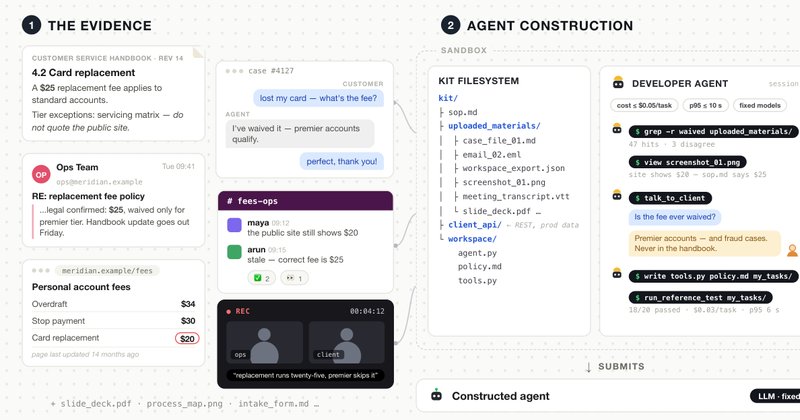
O hyper-tau-bench, publicado no arXiv em 4 de setembro de 2026, avalia se agentes de IA conseguem construir agentes de atendimento completos. Claude Opus 5 sob Claude Code passou em 23,9% das simulações, contra 82,2% do teto escrito por especialistas.
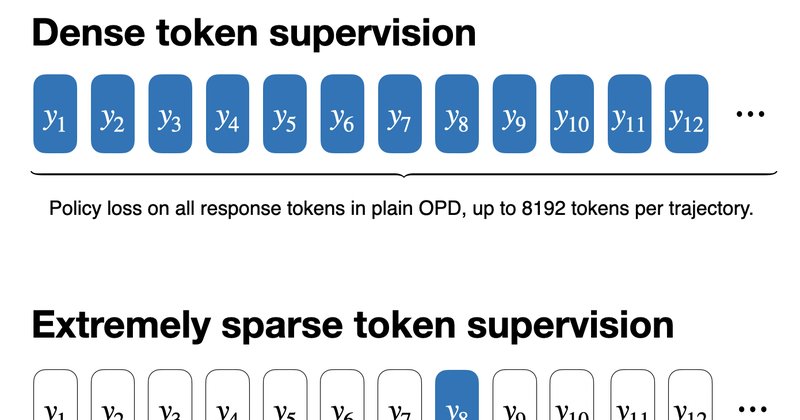
Estudo no arXiv mostra que supervisionar apenas 0,05% dos tokens, um ou dois por trajetória, iguala ou supera o treino completo no pós-treinamento de LLMs. O resultado foi validado em nove configurações professor-aluno com Qwen3 e Llama.
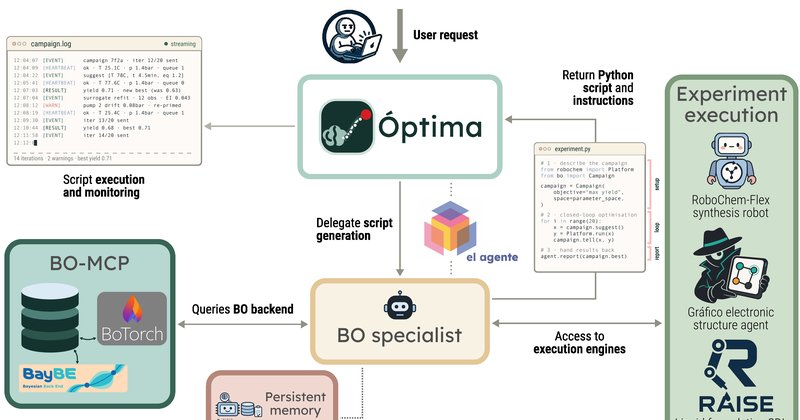
Framework de IA apresentado no arXiv em setembro de 2026 supervisiona campanhas de otimização bayesiana em laboratórios autônomos sem especialistas humanos. Em química em fluxo, elevou o rendimento de 30% para 59% em 23 experimentos e cinco dias.
Método sem retreino, publicado no arXiv em setembro de 2026, reduz as alucinações do Whisper de 31,31% para 2,44% em áudio sem fala, com trade-off medido na precisão de transcrição.